大きなペイロードが大規模キャッシュを不安定にする理由
大規模な Valkey の性能低下は、単一の大きすぎるオブジェクトより、トラフィックの形、イベントループの負担、実際の状態に反応する保護策の不足に起因します。Unlocked San Jose での Apple と Snap の教訓を紹介します。
 Allen Helton
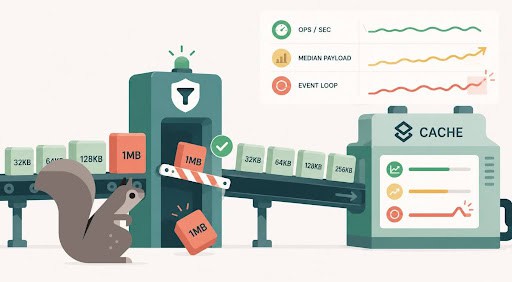
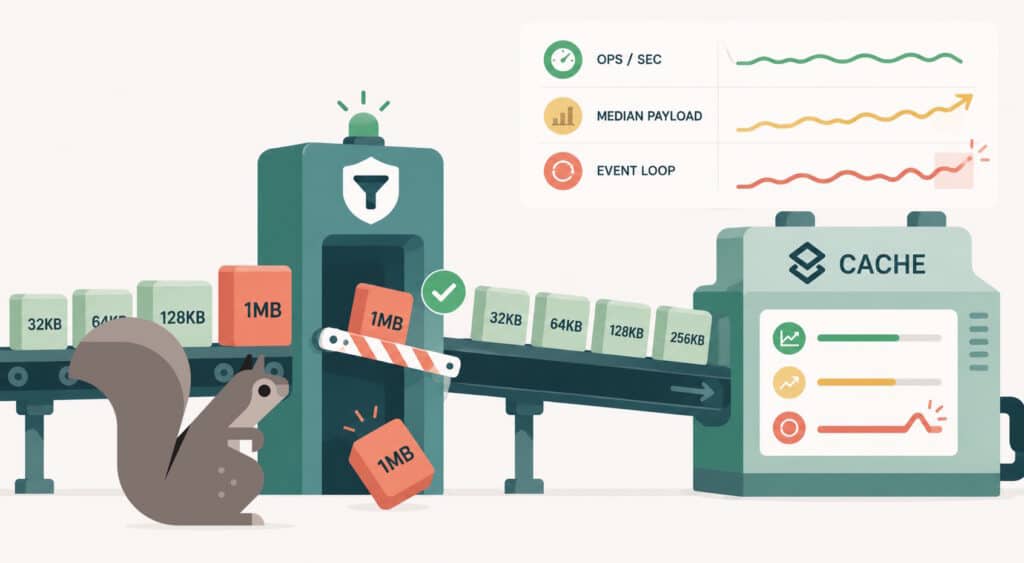
Valkey を本番で運用しているなら、どこかにペイロード上限を設定し、大きすぎるオブジェクトからキャッシュを守れると考えたことがあるでしょう。しかし大規模なキャッシュ障害は、1つの巨大なペイロードから起きるわけではありません。望ましくない形の何千ものリクエストが、悪いタイミングで届くことで起きます。
例えば Apple のシステムでは、大きなペイロードが集中した際に ping のレイテンシが300msから1秒以上へ跳ね上がりました。そのインスタンスの入力スループットは7.5 MB/sから75 MB/s、出力は29 MB/sから185 MB/sへ増えました。どのデータも初期設定の512MB上限には程遠い大きさでした。それでも中程度のデータが急増すると、リクエスト処理経路が飽和し始め、システムが崩れ始めました。
Valkey 9.0 のコピー回避は、読み取り経路の障害要因の1つを解消しました。しかし、累積ペイロード量、コマンドの形、書き込み経路でのメモリ割り当ての負荷は、それぞれ別の要因としてクラスター性能を悪化させる可能性があります。
Unlocked で、Apple の Yiwen Zhang と Snap の Ovais Khan は、ペイロードサイズが基盤の異なる場所へ圧力をかける本番システムについて説明しました。どちらも、自ら仕組みを作って乗り越えた問題です。その内容と、保護のロジックをどこに置くべきかを紹介します。
イベントループのボトルネック
Valkey のすべては、シングルスレッドのメインイベントループを通ります。読み取り、書き込み、コマンド解析、応答の構築が実行時間を奪い合います。大きなペイロードの問題を理解するには、ここから始める必要があります。
Yiwen は、Valkey のレイテンシはイベントループが処理中である時間と、ブロックされる時間の結果だと説明しました。大きなペイロードが加わると、イベントループへの負担が増え、他の処理に使える時間が減ります。
読み取り経路で大きな GET の高コストな処理は、応答の構築です。Valkey 9.0 より前は、I/O スレッドへ渡す前に、メインスレッドで値全体を応答バッファーへコピーしていました。5MBの GET は、5MBの memcpy がループを止め、他のすべてのクライアントを待たせることを意味します。
Valkey 9.0 のコピー回避は、通常のクライアント、RAW エンコーディング、16KBまたは64KBの制限を超えるオブジェクトなど、いくつかの条件でこの問題を改善します。メインスレッドは値をコピーせず参照を書き、I/O スレッドが転送を処理します。これにより、少数の大きな GET がメインスレッド上で小さなリクエストを止める、最も目立つノイジーネイバー問題が解消されます。
運用者は proto-max-bulk-len で書き込みのペイロードサイズを制限できます。しかし大きな GET には同等の上限がありません。時間とともに成長した list のような10MBの値は、書き込み側の制限にかかわらず返され、イベントループへ負担をかけます。
負担は多数のリクエストから徐々に蓄積することも、1つの外れ値的リクエストで急増することもあります。十分な数の大きな GET が近接して届くと、シリアライズ時間がイベントループを支配します。どのリクエストも上限に近くなくても、システムは悪化します。
大きな SET にもコピーの問題がある
理論上、Valkey は受信時のメモリ割り当てとコピーを省略できます。32KB以上のペイロードでは、クエリバッファーを保存する値として直接再利用できます。ただしオフセット0に整列し、その値だけを含み、他のものが入っていない必要があります。パイプライン化したワークロードでは常に他のデータも入るため、大半の大きな SET は解析段階で全体のメモリ割り当てと memcpy を行います。
Valkey 8.0 の I/O スレッドはこの問題を改善します。解析段階の割り当てとコピーが、メインスレッドではなく I/O スレッド上で実行されるようになりました。Yiwen の256KB SET の測定(128クライアント、パイプライン深度4)では、I/O スレッド1本から4本へ増やすと、1サイクルあたりのイベントループ時間が約171 µsから約93 µsへ下がりました。スループットは約13.3k RPSで横ばい、p99 は約10%改善し、67msから60msになりました。コピー自体は残っていても、メインスレッドの時間を取り戻せたのです。
サイズより先に、処理の形が性能を崩す
Ovais は、大きなバッチの MGET が Snap で性能退行を起こしたことを説明しました。個々の値のサイズではなく、コマンドと Valkey のクラスター構造の相互作用が原因でした。
Valkey の MGET はスロット単位です。各キーはハッシュスロットに対応し、クラスターではスロットが特定ノードにあります。複数スロットをまたぐ MGET は単一ノードで処理できず、CROSSSLOT エラーになります。クライアントはスロットごとの小さなバッチに分け、結果を組み立て直す必要があります。
Snap が支援する Redis のフォークである KeyDB には、Cross-Slot MGET という独自機能がありました。キーがどのスロットに属するかにかかわらず、あるノード上のすべてのデータを1コマンドで問い合わせられます。Snap の一部ワークロードは、スループットのためにこれに依存していました。Valkey への移行でそれらが遅くなり、Snap は同等の性能を取り戻すため、社内で Cross-Slot MGET を移植しました。現在は上流のメンテナーと協力してプロジェクトへ取り込もうとしています。
コマンドの形は、ペイロードのバイト数とは別の形でシステムへ負担をかけます。対象キー数、スロットへの分散、応答を連携させる方法は、それぞれ性能に影響します。毎秒数億コマンドを処理する Snap の規模では、この違いがすぐに積み重なります。
クラスター前段の RESP プロキシも、追加の負荷箇所になります。遅いコマンドが、パイプラインの後続を止めることがあります。Snap は重要な用途で接続数を増やし、パイプライニングを制限して、ヘッドオブラインブロッキングを緩和しました。根本はコマンドの形です。大きなバッチコマンドは、小さな個別リクエストより長くプロキシのパイプラインを占有します。
こうした要因を理解しても、本番で特定するのは難しいままです。既存のメトリクスは、ワークロードが時間とともにどう変わるかを捉えていないためです。
ペイロードの変化は見えない
Valkey は、毎秒のバイト数、操作数、イベントループの健全性、SLOWLOG、大きなリクエストと応答の診断など、充実したシステムメトリクスを提供します。しかし、ペイロードサイズの分布を継続的に見る機能がありません。100MB/sというスループットは、1MBを100回でも、5MBを20回でも同じです。しかしイベントループへのコストは大きく異なります。
Yiwen は、既存のメトリクスに request_payload_bytes_bucket と reply_payload_bytes_bucket の2つを追加することを提案しました。リクエストと応答をサイズ範囲ごとに分類すれば、運用者はトラフィックの形の変化を検出できます。ペイロードの中央値は、アラートが1つも出ないまま、何週間もかけて徐々に増えることがあります。
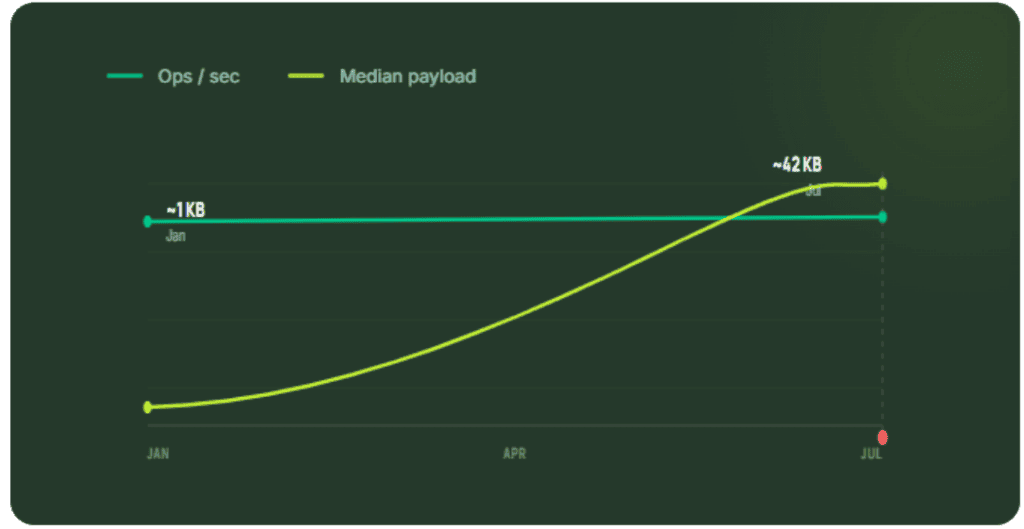
実行時の保護策は分布と傾向に反応し、静的な制限は取り込み時点の絶対値に反応します。ペイロードの変化に対処するには、両方が必要です。
エンジンより上に保護策を置く
Snap では、アプリケーションは Valkey に直接接続しません。ストレージの抽象化層に接続し、その層が RESP プロキシを介して Valkey へつながります。そのためアプリケーションチームが変更を意識せず、KeyDB から Valkey へ移行できました。部分的な MGET 失敗の処理やゾーンを考慮したルーティングなども、アプリケーションのコードを変えずにカスタマイズできました。
Snap はエンジン内にも実行時の保護策を追加しました。Valkey に CPU スロットリングを移植し、使用率が95%を超えると書き込みを抑制して、管理コマンドの容量を確保します。実際のシステム状態に基づいて保護が働きます。バイト数のしきい値だけではできないことです。
プロキシ層は、独自の MGET 処理、部分失敗の動作、ヘッドオブラインブロッキングを減らす接続数調整など、大きなペイロードの問題を吸収する場所になりました。これらをインフラへ移すことで、各アプリケーションチームが個別に責任を持って実装する必要がなくなりました。問題をすべてのアプリケーションに広げず、インフラ層にとどめられたのです。
Ovais は、優れた抽象化がリスクの高い移行を運用作業へ変えると述べました。Snap の移行は、完全に手作業不要のツールによって、ピーク時に週約30キャッシュを達成しました。講演時点で約350キャッシュの70〜80%が移行済みで、アプリケーションチームの大半は進行中だと気づいていませんでした。エンジンより上に保護策を置くことで、これが可能になります。
可観測性を優先する
今すぐできる最も実用的なことは、キャッシュの監視にペイロードサイズの可視化を加え、変化を捉えることです。半年前には中央値1KBだったワークロードが今は40KBになっていると、深夜のレイテンシ障害になる前に気づけることを目指してください。
Valkey 8.0 と9.0は、キャッシュのアーキテクチャを大きく改善しました。書き込み経路の I/O スレッドと、読み取り経路のコピー回避は、どちらも大きなペイロードによるイベントループの負担を減らします。それだけで性能曲線は変わります。しかし、自分のワークロードが曲線のどこにあるかを知るには、引き続き計装が必要です。実際のシステム状態に反応する保護策も、その上に構築しなければなりません。
ペイロード上限は今も重要ですが、戦略全体ではなく、最初の防衛線になりつつあります。現代のキャッシュには、トラフィックの形を捉える可観測性と、変わる状況にリアルタイムで対応する保護策が必要です。
本記事は、Yiwen Zhang(Apple)による Valkey の大きなペイロードへの保護策と可観測性、および Ovais Khan(Snap)による350以上のキャッシュクラスターの KeyDB から Valkey への移行に関する講演をもとにしています。録画全編は unlockedconf.io/san-jose-replays で視聴できます。