大きなオブジェクトによる性能悪化を Valkey 9 が抑える
性能の約束が崩れるのは、テールレイテンシです。99% の時間は高速でも、ユーザーが覚えているのは残りの 1% です。
 Khawaja Shams
 Brian Martin
1 KB のオブジェクトを毎秒 100K リクエストで処理する Valkey クラスターは、快調に動いていました。レイテンシも安定していました。そこへ、誰かが 10 MB の大きなデータを少し取得し始めました。毎秒わずか 10 リクエストです。それだけで、小さなオブジェクトのワークロードが崩れました。
メディア分野では、10 MB のアイテムは珍しくありません。Momento をライブ配信のオリジンとして使い、動画セグメントをキャッシュする場合などです。ここではテールレイテンシが大きな意味を持ちます。p99 の急上昇はバッファリングにつながり、バッファリングは視聴者の離脱につながります。特にマルチテナントシステムでは、一つのワークフローが扱う大きなアイテムが、他の利用者全員の体験を損なう可能性があります。
問題
ベースラインは、1 KB の GET を合計 100K req/s で処理する構成です。256 接続に分散し、各接続で 32 リクエストをパイプライン化しました。そこへバックグラウンドトラフィックとして、10 MB の GET を 10 req/s 加えました。大きなオブジェクトへのリクエストは、毎秒わずか 10 件です。
Valkey 8.1 で、1 KB のリクエストのレイテンシに起きたことを見てください。
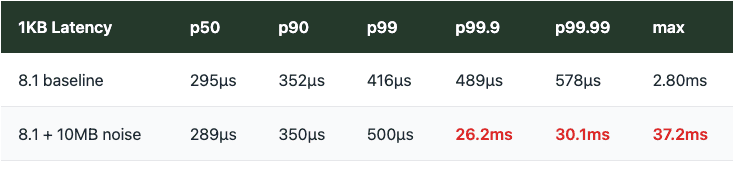
p50、p90、p99 はほとんど変わりませんでした。しかし、テールレイテンシは跳ね上がりました。p99.9 は 489μs から 26.2ms へ、53 倍の悪化です。わずかな大きいオブジェクトの取得が、他のすべての利用者の体験を損なっていました。
ただ、Valkey には I/O スレッドがあります。I/O スレッド数に応じてスループットがほぼ線形に伸びることも確認済みです。メインスレッドをブロックせず、ネットワークトラフィックを処理できるはずではないでしょうか。
仮説
Valkey 9.0 には、応答時のコピーを回避する仕組みが入っているとわかっていました。メインスレッドで大きなオブジェクトを応答バッファーへ memcpy する代わりに、ポインター参照だけを渡し、実際のデータ転送を I/O スレッドに任せるという考え方です。
メインスレッドが 10 MB の memcpy 処理でブロックされていたのなら、小さなリクエストが滞る理由を説明できます。コピーを取り除けばブロックもなくなり、問題は解決する。それが仮説でした。
コピー回避の仕組み
9.0 より前は、大きな文字列を返す際、メインスレッドがオブジェクト全体を応答バッファーへ memcpy してから、次の処理へ進んでいました。GET ごとに 2 回のコピーが発生します。
変更前(Valkey 8.1)
合計メモリ帯域幅:GET あたり 20 MB。
Valkey 9.0 では、この流れが変わります。メインスレッドは 10 MB をコピーする代わりに、16 バイトの参照を書き込んで、次へ進みます。
変更後(Valkey 9.0)
メインスレッドのコピー帯域幅:約 0。ポインターと参照を管理するだけです。
I/O スレッドは、obj->ptr を直接指す iovec を作り、writev() を呼び出します。負荷の大きな処理は、コマンド実行と並行して行われます。
共存できる状態へ
コピー回避で、ノイジーネイバーの問題は解決するのでしょうか。両方のバージョンで、混合ワークロードのテストを実行しました。
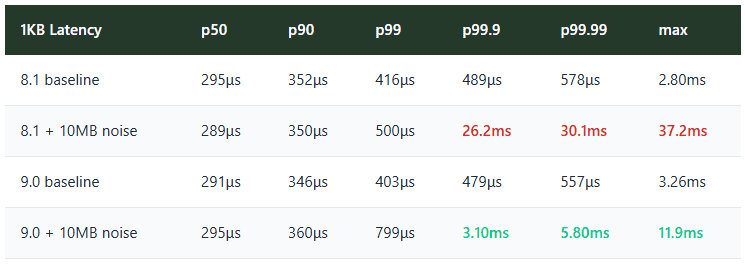
9.0 では、大きなオブジェクトのトラフィックは、小さなオブジェクトのワークロードに実質的な影響を与えません。p99 は 8ms のままです。メインスレッドが memcpy でブロックされないため、大きなリクエストの処理中も、小さなリクエストが流れ続けます。
場を乱す大きなオブジェクトを追い出したわけではありません。適切な場所へ案内し、他の処理と問題なく共存できるようにしたのです。
表に出ていない設定
この改善を得るために、チューニングは必要ありません。最適化は、デフォルトの設定ファイルには載っていない三つの設定で制御されています。いわば隠れた設定項目です。デフォルト値は妥当なものになっています。
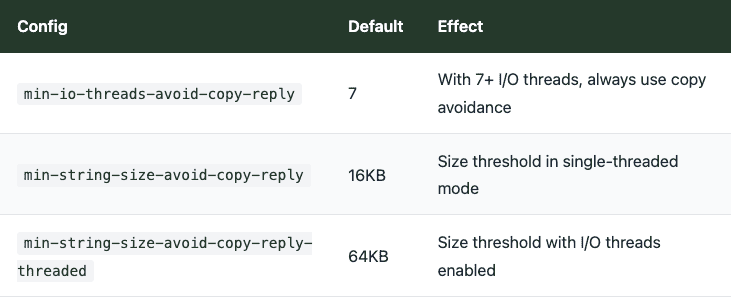
ほとんどのユースケースでは、デフォルト値で十分です。特定のワークロードに合わせて調整したい場合も、どこを見ればよいかがわかりました。
これは、コミュニティ主導で進む Valkey の数多くの最適化の一つです。一つひとつは小さな改善でも、積み重なると大きな効果になります。PR #2976 のような今後の変更にも期待しています。読み取りコマンドを完全にワーカースレッドへオフロードし、読み取り経路からメインスレッドを外すものです。
実際の利用場面でキャッシュの性能問題に直面している方は、ぜひお聞かせください。ワークロードの特徴をより正確に捉える助けになりますし、再現可能な結果を皆さんと共有することも楽しみにしています。
パラメーターの動作について助言し、ベンチマーク手法へ技術的なフィードバックをくださった Madelyn Olson に、特に感謝します。