Valkey の 1 周年:コミュニティのフォークが Redis を大きく上回るまで
Valkey は成長を続けるだけでなく、実環境に近いベンチマークで Redis 8.0 を上回る性能を示しています。
 Khawaja Shams
1 年前、Redis Inc(旧 Garantia Data)は、オープンソースのエコシステムを揺るがす物議を醸す決定を下しました。Redis をクローズドソース化したのです。当時の記事で書いたように、それは信頼を損ない、コミュニティを分裂させかねない決定でした。
しかし、コミュニティは分裂することなく、目的を持って応えました。その混乱から生まれたのが Valkey です。コミュニティを存続させることに挑んだフォークでした。
復帰と方針転換
コミュニティとの信頼関係を再構築する取り組みの一環として、Redis Inc は Redis の生みの親である Salvatore Sanfilippo(通称 Antirez)を再び迎え入れました。私は彼の復帰を喜んでいます。すでに効果が表れているからです。彼は Redis の新機能と性能最適化に貢献するという約束を実行しています。さらに大きな変化として、Redis 8.0 は再びオープンソースになりました。
Redis は SSPL の採用がコミュニティとの関係に負担をかけたと認める一方、他者の貢献についても問いかけました。「クラウド事業者が、利用するプロジェクトに相応の貢献を返さずに利益を得てインフラを支配する状況で、OSS プロジェクトの革新と投資をどう続ければよいのでしょうか」。
Redis Inc の残念な決定は、かつてない協力と貢献の波を生みました。Valkey は、結束を保とうとするコミュニティの決意を試す場となりました。1 年後、Valkey は生き残っただけでなく、力強く成長しています。AWS が提供した非同期 I/O スレッドモデルは、Redis 内の I/O スレッドの動作を根本から変え、3 倍以上のスループットを実現しました。
こうした貢献は Redis 8 と比べてどうなのでしょうか。8 vCPU のインスタンス(c8g.2xl)で、Valkey 8.1 または Redis 8.0 は 1M RPS に達するでしょうか。条件は 1KB の項目、300 万項目のキー空間、約 500 接続です。比較してみましょう。
Valkey 8.1 対 Redis 8.0:フォークは元のプロジェクトを超えられるか
結果から言うと、8 vCPU のインスタンスで 1M RPS を持続することは、Valkey でも Redis 8.0 でもできませんでした。ただし、非常に近いところまで到達しました。
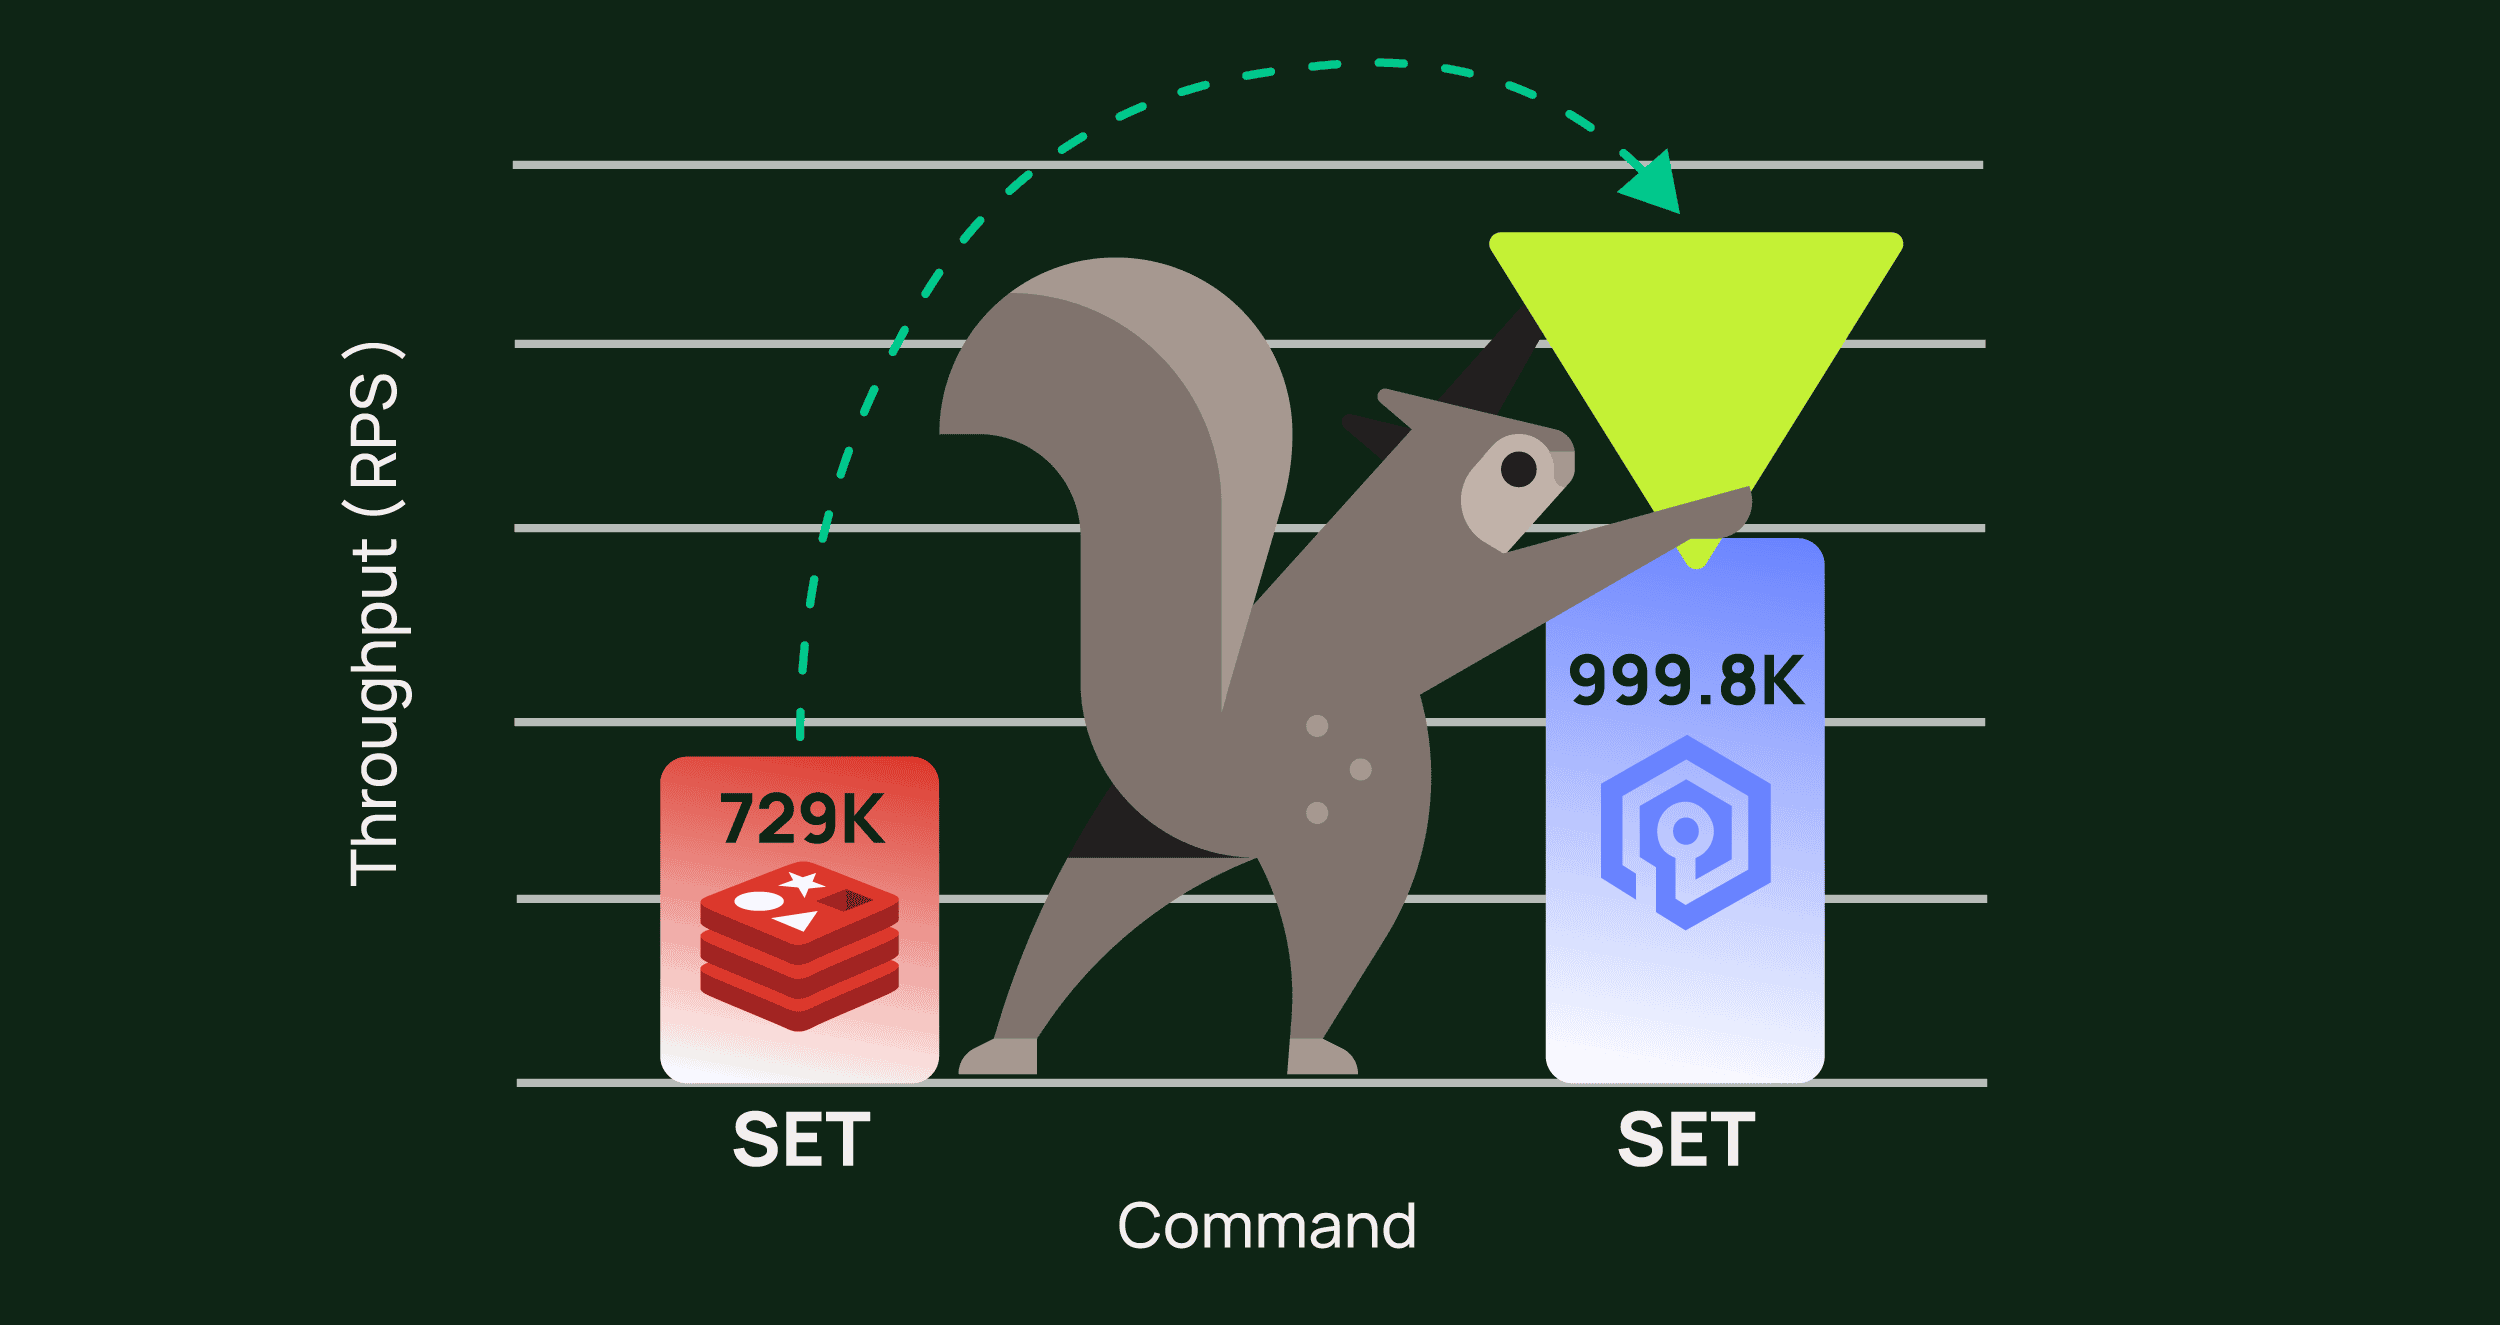
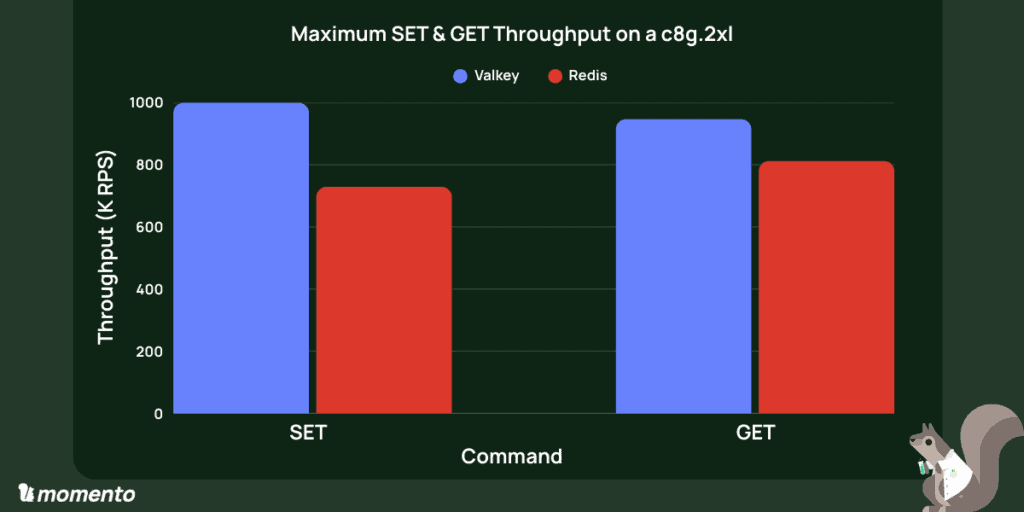
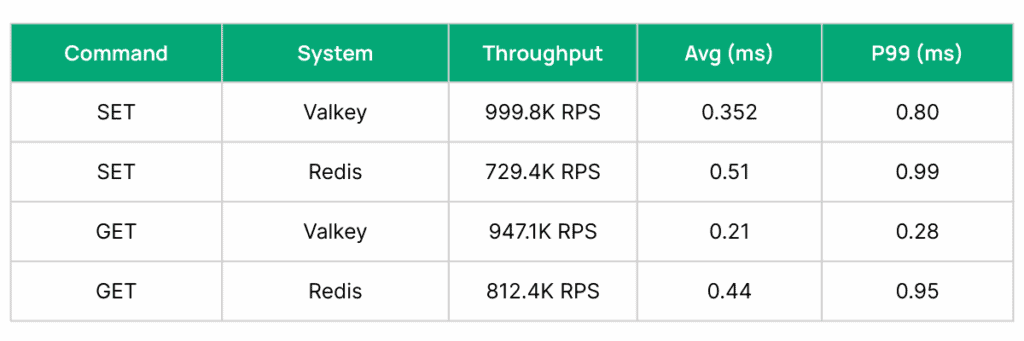
十分に調整した c8g.2xl(8 vCPU)で、Valkey 8.1.1 は SET のスループット 999.8K RPS、p99 レイテンシ 0.8ms を達成しました。Redis 8.0 は SET で最大 729.4 RPS、p99 レイテンシ 0.99ms でした。各回では 5,000 万回の SET に続いて 5,000 万回の GET をテストしました。各システムの最大スループットを最適化するため、接続数を変えて測定しています。
Valkey は読み取りと書き込みの両方で高いスループットと低いレイテンシを達成しました。スループットは SET で 37%、GET で 16% 高く、p99 レイテンシは SET で 30%、GET で 60% 以上高速でした。
マルチスレッドを生かすための工夫
「でも Redis / Valkey はシングルスレッドでしょう」という言葉を、これまで何度聞いたことでしょう。
Antirez が重視してきたシェアードナッシングのアーキテクチャは、Redis の基盤です。それでも Redis は早くも 2020 年に I/O スレッドに対応しました。残念ながら、最近まで大幅な改善は得られませんでした。以前 I/O スレッドを試して採用を見送った方も、今こそ再評価する時です。
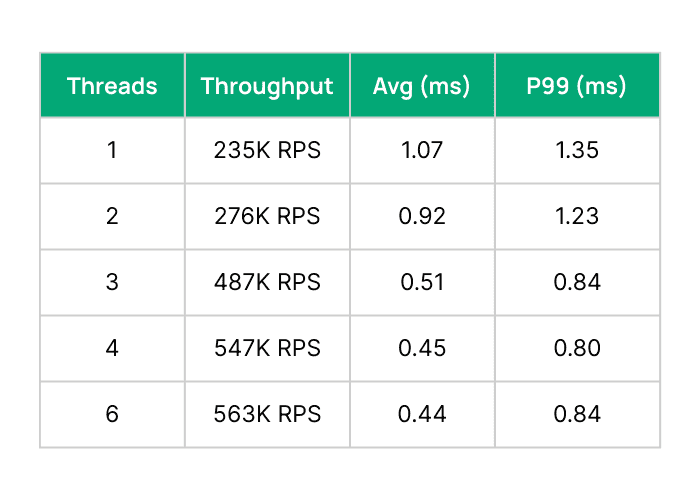
Valkey では、I/O スレッドなしで 239K RPS だった SET スループットが、6 スレッドで 678K RPS に向上しました。スループットがほぼ 3 倍になったにもかかわらず、p99 レイテンシは 1.68ms から 0.93ms に低下しました。同様に Redis も、I/O スレッドなしの 235K RPS から、6 I/O スレッドで 563K RPS になりました。Redis の p99 も 1.35ms から 0.84ms へ約 40% 低下しました。
重要な点は 2 つあります。
- 2 スレッドでは改善は約 20% と控えめでした。効果が顕著になったのは 3 スレッド以上です。
- 4 スレッドまでは Redis と Valkey が拮抗していました。それ以降、Valkey が大きく引き離しました。
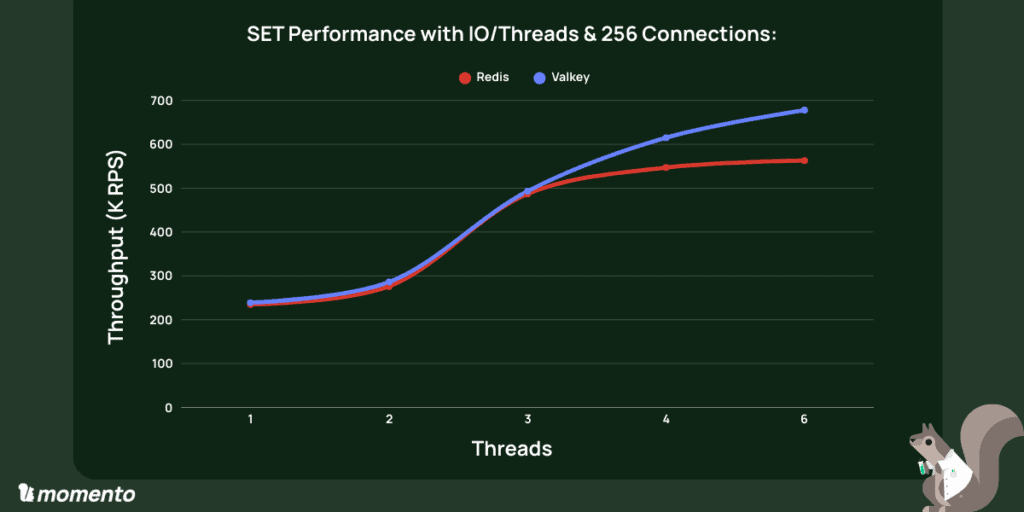
I/O スレッド、256 接続での Valkey の SET 性能
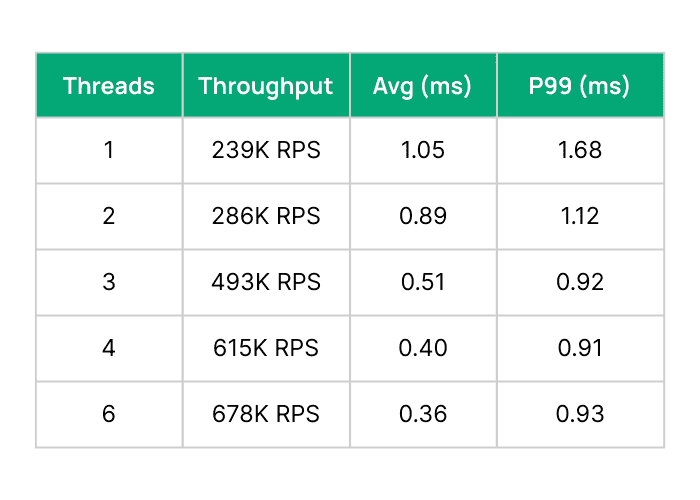
I/O スレッド、256 接続での Redis の SET 性能
Valkey のスループットをさらに引き上げる
前節では、Valkey が 6 スレッド、256 接続で SET 678K RPS を達成することを確認しました。接続数を 400 に増やすと、スループットは 832K RPS になります。そこからさらに 167K RPS を得るにはどうしたのでしょうか。
私たちが愛用する Linux 性能テレメトリーエージェント Rezolus を使い、高負荷時のシステムを詳しく調べました。下のグラフでは、全体の CPU 使用率は約 80% で、8 コア間に偏りがあることが分かります。
さらに調べると、8 コアすべてでネットワークキューからハードウェア割り込みが発生していました。割り込みは、処理中の Valkey スレッドを中断し、ネットワークパケットの処理に CPU を譲らせるため、不利に働きます。
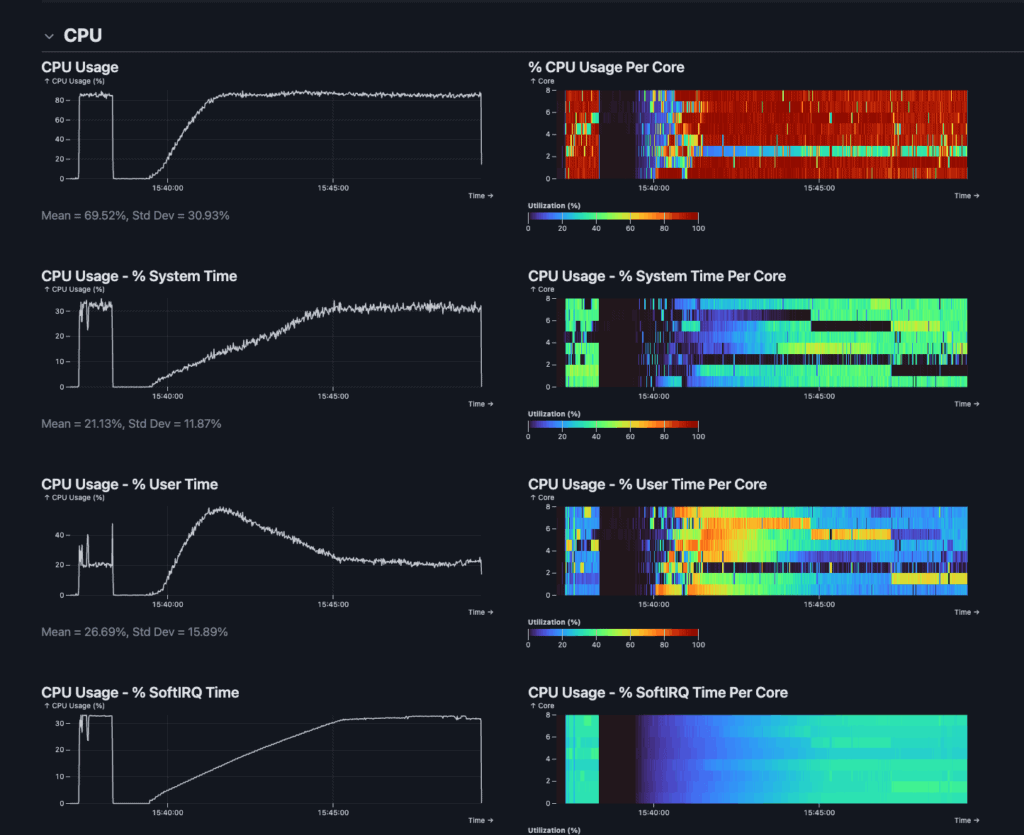
8 コアの c8g.2xl でコンテキストスイッチを避けられたらどうでしょうか。100 万 RPS に近い処理には、相当なパケット処理能力が必要です。幸い、EC2 インスタンスでは多くの処理を Nitro 層で行うため、IRQ の処理に専念させれば 2 コアの割り当てで十分です。IRQ を 2 コアに固定するのは難しくありません。
sudo ethtool -L ens34 combined 2 # reduce to 2 IRQs
grep ens34 /proc/interrupts # ours were on 99 and 100
echo 1 | sudo tee /proc/irq/99/smp_affinity # pin 99 to core 1
echo 2 | sudo tee /proc/irq/100/smp_affinity # pin 100 to core 2
では、これらのスレッドを専念させ、Redis / Valkey のスレッドが同じコアで競合するのをどう防ぐのでしょうか。Redis / Valkey をコア 3~8 に固定し、I/O スレッドの分離を改善しながら IRQ も専用コアで処理させます。Docker の --cpuset-cpus フラグで CPU を割り当て、テスト中は Redis と Valkey のプロセスが指定したコアに固定されるようにしました。これによりコア間の競合が減り、キャッシュの局所性が向上します。どちらも高スループット時のテールレイテンシを抑えるために重要です。 マルチテナント環境や混在ワークロードでは最適なコア割り当てが変わることもありますが、このベンチマークではシステム処理とアプリケーション処理を明確に分離できました。
Redis:
docker run --network="host" --rm \
  --cpuset-cpus="2-7" redis:8.0 \
  --save "" --appendonly no \
  --io-threads 6  \
  --protected-mode no --maxmemory 10gb
Valkey:
docker run --network="host" --rm \
  --cpuset-cpus="2-7" valkey/valkey:8.1.1 \
  --save "" --appendonly no --io-threads 6 \
  --protected-mode no --maxmemory 10gb
IRQ を最初の 2 コア、Valkey を残りの 6 コアに固定した構成を Rezolus で確認します。まず、CPU 使用率が大きく上昇しました。次に、下の SoftIRQ グラフでは、処理が最初の 2 コアだけに限定されています。さらに、以前はコアごとの使用率がばらついていたのに対し、Valkey のコアが高い使用率で稼働しています。この構成は今回のベンチマークには適していますが、最適な IRQ 調整は NIC のアーキテクチャとアプリケーションの並行処理モデルに大きく左右されます。
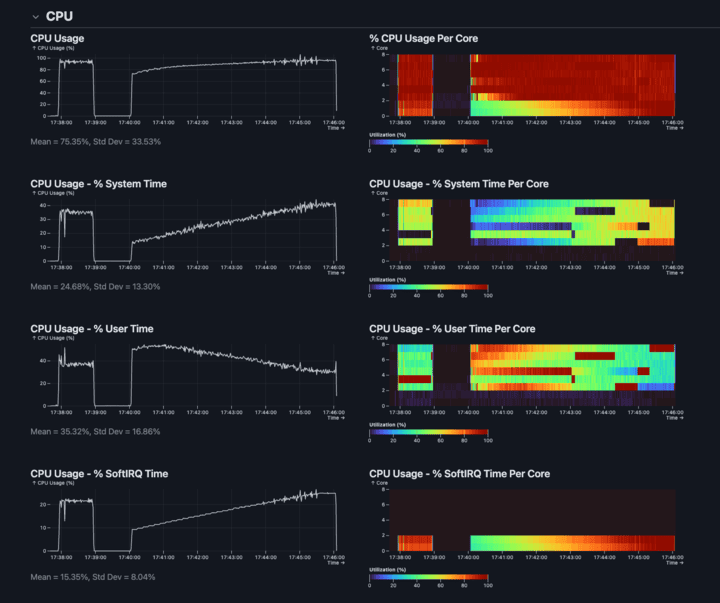
CPU 使用率の追加の 20% が、167K RPS の上積み(832K RPS から 999.8K RPS)につながりました。
自分で試すための手順と留意点
このベンチマークが終点ではなく出発点になればと考えています。Valkey と Redis の両コミュニティが、引き続き性能改善に取り組むきっかけになることを願っています。また、自分のワークフローの特性を取り入れて、自分の環境で再現したい方も多いでしょう。以下に、自身の AWS アカウントで 1 時間以内に再現するための主な手順を示します。
インスタンスタイプ: 2024 年 9 月に登場した AWS Graviton4 ベースの c8g インスタンスを使いました。サーバーノードの c8g.2xlarge は 8 vCPU(us-east-1 で月額約 $250)、負荷生成用の c8g.8xlarge は 32 vCPU です。これにより、ベンチマークの負荷、IRQ 処理、Redis / Valkey の処理を分離するために十分な CPU の余力が得られました。同じ c8g.2xl インスタンスで Valkey と Redis を一度に片方ずつ実行し、負荷生成にも毎回同じノードを使いました。公平性のため、各テストの直前に Valkey と Redis を再起動しています。
プレイスメントグループ: クライアントとサーバーノード間のネットワークジッターを最小化し、低レイテンシで通信するため、EC2 プレイスメントグループのクラスターモードを使いました。EC2 インスタンス間のホップ数が減るため、極めて安定した低レイテンシが得られます。スループット向上、中断の減少、低レイテンシという利点がありますが、障害の相関や影響範囲にも関わるため、本番環境への導入前に検討が必要です。
コア固定: 最大スループットと最小レイテンシを得るには、コアの固定と IRQ 数の削減を検討してください。8 コアのインスタンスで使用した具体的な手順は前節を参照してください。テストノードにも同様の手法を適用することが重要です。
接続数を変える: 接続数は Redis と Valkey の両方で、想像以上に重要な変数です。どちらも 1024 接続に近づくとレイテンシが急上昇します。例えば Valkey は 400 から 1024 接続に増やすと、SET スループットが 999.9K RPS から 969K RPS に低下し、p99 レイテンシが 0.8ms から 1.6ms に倍増しました(2048 接続では p99 が 3 倍になります)。Redis は 384 から 1024 接続に増やすと、スループットが 729.4K RPS から 668K RPS に低下し、p99 は 0.99ms から 2.5ms と 2 倍以上になりました。スループットが下がり、レイテンシは上がるのです。接続数の調整が重要な理由が分かるでしょう。
キー空間: 最良の数値を出すだけなら、小さい値と極めて小さいキー空間(-r 10000)を使うとよいでしょう。すべてを L3 キャッシュから取得しやすくなります。今回はより実環境に近づけるため、1KB の項目(-d 1024)と 300 万のキー空間(-r 3000000)を使いました。
ベンチマークアプリもマルチスレッドにする: valkey-benchmark で最大スループットを得るには、ベンチマークツール側のマルチスレッドも有効にしてください。--threads 6 フラグで valkey-benchmark をマルチスレッドモードで実行できます。
ベンチマークコマンド:
docker run --network="host" --rm --cpuset-cpus="2-7" \
valkey/valkey:8.0.1 valkey-benchmark \
-h 172.31.4.92 -p 6379 -t SET,GET -n 100000000 -c 256 \
-r 3000000 --threads 6 -d 1024
最後の留意点:ベンチマークは本質的に不完全
実環境のワークフローに近づけるためにできる限り工夫しましたが、改善の余地はあります。Valkey-bench も完璧ではありません。私たちには改善したい点があり、Valkey プロジェクトにもあります。
第一に、現在は特定の TPS を目標にするのではなく、サーバーが処理できるだけの負荷を送ります。現実のトラフィックは、サーバーのレイテンシに合わせてスループットを調整してくれることはほとんどありません。第二に、特定の負荷を指定できるようになったら、一定のスループットを続けるだけでなく、負荷を増減させて山や谷を再現できれば、さらに実環境に近づきます。最後に、Key-Value キャッシュのワークフローで GET が 100%、あるいは SET が 100% という状況はまれです。SET:GET の比率を指定して、システムの反応を確認できるようにしたいと考えています。
Momento では通常、rpc-perf を使ってテストします。すべて Rust で書かれており、上の 3 つの機能要望のような実環境に近いシナリオに対応し、Rezolus とも非常によく連携します。それでも rpc-perf は合成ベンチマークです。本番ワークフローのシミュレーションの自由度は高いものの、結果があらゆるワークフローに当てはまると考えるべきではありません。小さな変数が大きな差を生み、シミュレーションは本番そのものにはなれません。
最後に:性能は継続的な実践から生まれる
Valkey は進歩に追随するだけでなく、進歩を先導しています。性能の上限も上がり続けています。しかし、そこに達するには、システム、インフラ、ワークロードの振る舞いに関する専門知識が必要です。
Momento は日々、チームがこのような性能を達成できるよう支援しています。Valkey や Redis を運用している方も、選択肢を検討中の方も、安心してスケールできるようお手伝いします。
リアルタイムインフラの調整に支援が必要ですか。ご相談ください。
rpc-perf や Rezolus などのツールと、このベンチマークへの知見を提供してくださった IOP Systems の Yao と Brian に感謝します。