分散キャッシュの NxM 問題を理解する
N 個のクライアントがそれぞれ M 個のノードに接続すると、接続負荷は乗算的に増えます。大規模な環境で NxM 問題が生じ、日常的な運用で接続ストームが起こる仕組みを解説します。
 Allen Helton
大規模なシステムの多くは、一つの悪い判断が原因で障害を起こすわけではありません。それぞれは合理的だった複数の判断が、初期には考える必要のなかった形で相互作用し始めるために、障害が起こります。
分散キャッシュも同じです。小規模なうちは単純で予測可能であり、動作を把握しやすいシステムです。クライアントはクラスターに接続し、データは適切な場所へ流れ、接続の維持を意識することはほとんどありません。
システムが成長しても設計上の判断はそのままですが、接続の維持が次第に重要になります。クラスターにもクライアントにも誤りはありません。規模が大きくなるにつれ、システムの形が変わるのです。
NxM 問題は、この成長に伴う痛みの中にあります。明白なものでも、新しいものでもなく、システムがかなり長く順調に動いた後で初めて現れることがほとんどです。
NxM 問題が拡大する仕組み
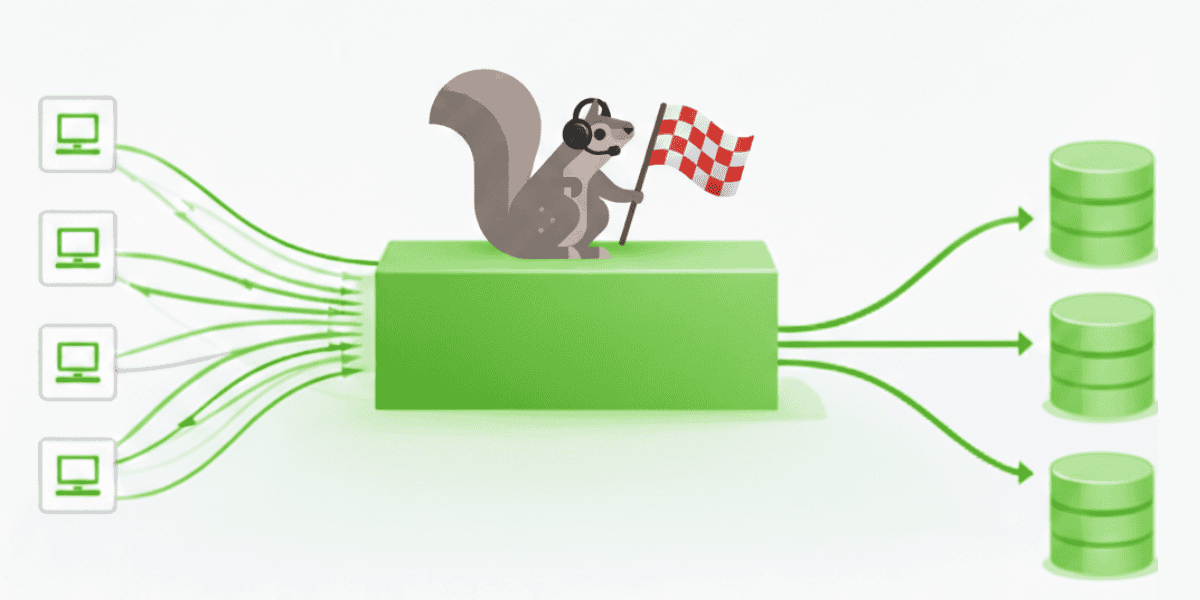
NxM 問題の本質は接続の負荷です。N 個のクライアントがそれぞれクラスター内の M 個のノードに接続すると、総接続数は N×M で増えます。接続数が線形に増えがちな通常のスケーリング課題と異なるのは、この乗算的な増加です。
Redis や Valkey のように、クライアントがクラスターノードへ直接接続する分散キャッシュでは、各アプリケーションインスタンスがデータの場所を把握し、自ら適切なノードと通信します。つまりクライアントはクラスター構成を認識します。トポロジーを検出し、シャードとレプリカの配置を理解して、通信する可能性のあるノードへ直接 TCP 接続を開きます。全体をシャーディングし、レプリケーションを行うクラスターでは、すべてのシャードとすべてのレプリカに接続を開くことになります。
小規模なら、これは単純で効率的に機能します。ただし、すべてのクライアントの接続がクラスター全体に広がることも意味します。
50 シャード、それぞれに 2 レプリカがある場合、プライマリを含めて 150 ノードです。一つのクライアントが全 150 ノードへの接続を維持します。アプリケーションインスタンスが 1,000 個なら、150,000 本の同時接続を管理します。まだ何も壊れてはいませんが、システムは変化に敏感になっています。
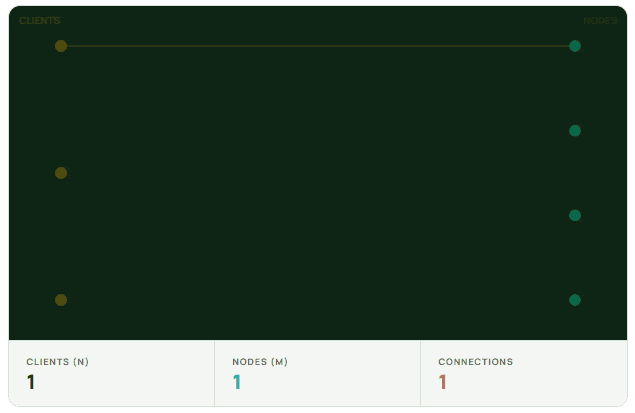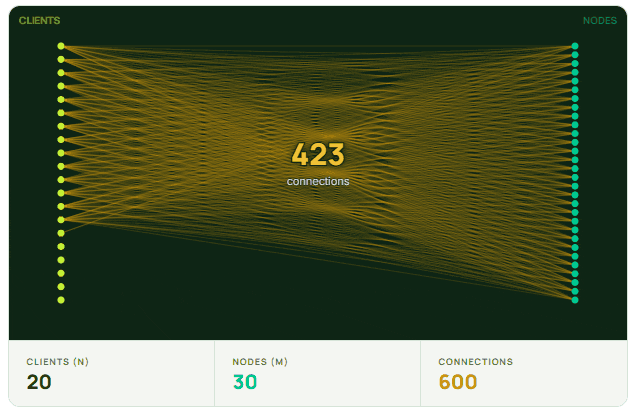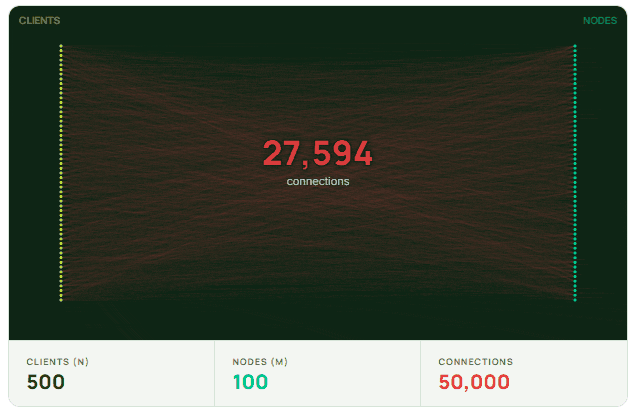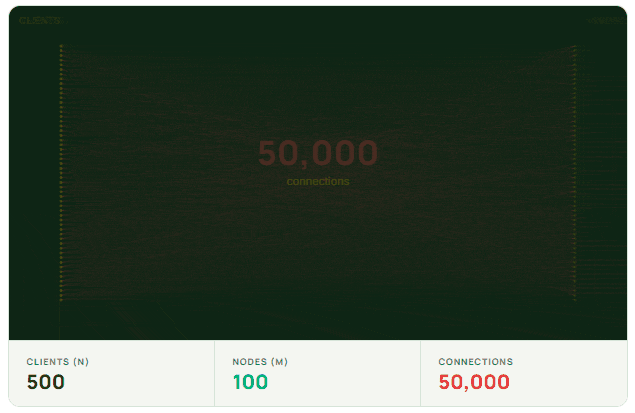
本当の問題はスケーリング時に始まります。現代のインフラではスケーリングは日常的な作業です。新しいアプリケーションインスタンスはコールド状態で起動し、それぞれが直ちに必要な全接続を確立しようとします。したがって、1,000 から 1,500 インスタンスへの拡張で増えるのは 500 接続ではありません。500 クライアント × 150 ノード、つまり 75,000 件の新規接続試行が、ほぼ同時にクラスターに押し寄せます。
これが接続ストームです。
「Redis ノードが遅くなると、数千のクライアントが同時に接続を閉じ、新たな接続を作ることがあります。そのリトライは負荷を和らげるどころか増幅し、障害につながるフィードバックループを生みます。」 — Shawn Wang、Uber Online Data Infrastructure Team、本番環境の 10 億 RPS から得たキャッシュの実践的教訓
接続ストームでキャッシュが停滞する理由
新しい接続ごとに、TCP ハンドシェイク、通常は TLS ネゴシエーション、認証、最初のコマンド処理が必要です。Valkey の各ノードでは、シングルスレッドのイベントループがこの作業を処理します。ストーム中は、リクエストを処理するよりも接続を受け付けることに多くの時間を費やします。
完全な TLS 1.3 ハンドシェイクは、証明書チェーンの検証、ECDHE 鍵交換、暗号方式のネゴシエーションに、約 2~3ms の CPU 時間を使います。たとえば 1,000 個の Pod が再起動し、それぞれが 20,000 本の新規接続を作るような波が発生すると、1 回 2ms のハンドシェイクにより、TLS 接続の確立だけで 40 CPU 秒を費やします。その負荷はバックエンドノードに不均等に分散します。
外からはクラスターが健全に見えることもあります。ノードは稼働し、スロットも均等です。それでもレイテンシは急増し、スループットは低下し、既存のクライアントはタイムアウトし始めます。システムが接続の入れ替わりに追従するだけで CPU サイクルを使っているためです。キャッシュのメトリクスは正常なのに、アプリケーション群はリクエストの処理に苦しみます。ここでデバッグが非常に難しくなります。
特に理解を難しくするのは、設定ミスがないことです。各クライアントは正しく動き、各ノードも仕事をしています。障害の要因は、クライアント数とノード数の乗算的な相互作用だけから生まれます。バグではなく、直接接続型アーキテクチャの構造的な特性です。
デプロイ中にキャッシュが遅くなる理由
商品データ、価格、在庫数、セッション状態の共有キャッシュとして Valkey を使う EC プラットフォームを考えてみましょう。ロードバランサーの背後にはステートレスなアプリケーションインスタンスがあり、それぞれのリクエスト経路に Valkey クライアントが直接組み込まれています。
複数のリージョンで約 5,000 のアプリケーションインスタンスが動作しています。低レイテンシと高スループットを維持するため、Valkey クラスターは 1,500 のキャッシュノードからなり、データをクラスター全体にシャーディングしています。
定常状態では問題なく動きます。ホットキーは効率的に処理され、ヒット率は高く、通常のトラフィック急増にも対応できます。
大型キャンペーンに備えて容量を追加することになりました。ごく日常的な作業です。スロットを再配置し、クラスターのトポロジーが変わります。
一つのアプリケーションインスタンスから見れば、特別なことではありません。クライアントがクラスター構成の情報を更新し、数本の新規接続を開くだけです。しかし、それが一度だけではなく、全アプリケーションインスタンスで 5,000 回、ほぼ同時に起きます。
症状はすばやく、予想外の場所に現れます。数千のクライアントが同時にトポロジー更新を解析し、スロットの対応関係を再計算するため、アプリケーションの CPU が急増します。各インスタンスが数百本の TCP 接続を一斉に確立しようとして、エフェメラルポートが枯渇します。暗号処理が CPU を奪い合い、TLS ハンドシェイクが待ち行列を作ってボトルネックになります。クライアントのリトライとバックオフの波によって、あるリージョンのストームが隣接リージョンの接続の激しい入れ替わりを引き起こし、障害が連鎖することもあります。
キャッシュの NxM 問題を示す兆候
NxM 問題は、事前に兆候をつかめれば対処しやすくなります。アラートになる前に、よくあるスケーリング問題と見分ける方法がいくつかあります。
一つ目は、トポロジー変更時に急増する一方、リクエスト数とは相関しないクライアント側の CPU 使用率です。スケーリング中、キャッシュへのリクエストレートが横ばいか低いのにアプリケーションの CPU が上限に達しているなら、クライアントはトラフィック処理ではなく、接続確立やスロットマップの再計算にサイクルを費やしている可能性があります。
接続確立のレイテンシが、クラスターの規模から予想する以上に増えていないかも確認してください。健全なシステムでは、ノードを 10% 増やせば接続のオーバーヘッドも比例して増えるはずです。次のスケーリングで観測レイテンシが 30% 跳ね上がるなら、NxM への感度が高まり始めています。将来のトポロジー変更が及ぼす影響範囲は、既に拡大しています。
オンコール担当者をよく困惑させるのは、日中は正常な p99 が、トラフィックの最も少ない午前 2 時のデプロイ時間帯に突然悪化することです。原因はほとんどの場合、新しいコードではありません。フリート全体の再起動により、全 Pod が同時に全クラスターノードへコールド接続し、ハンドシェイクの集中がイベントループの時間を奪っています。リクエスト数は一日の最低水準でも起こります。
最後に、あるリージョンの接続ストームで別のリージョンのレイテンシやエラーが増えるなら、接続の入れ替わりが共有インフラを通じて伝播している可能性があります。キャッシュクラスター自体は正常でも、接続管理のオーバーヘッドは正常ではありません。
大規模なチームはどう接続負荷を抑えるか
大規模な運用を行うチームは、いくつかの種類の緩和策を見いだしています。それぞれにトレードオフがあります。
最も取り組みやすい出発点は、段階的なロールアウトです。スロットをバッチ単位で移動し、間隔を空けることで、次のトポロジー変更までにクライアントが新しい状態へ収束する時間を確保します。指数バックオフとジッターを併用すれば、フリート全体でリトライのタイミングが分散し、トポロジー更新の失敗やタイムアウト時の thundering herd を防げます。これらは個々のイベントの影響範囲を狭めますが、根本の O(N×M) という接続構造は変えません。一度にすべてが問題化しにくくするだけです。
より構造的な解決策は、コネクションプーリング層やルーティングプロキシの導入です。クラスターに届く前にクライアント接続を集約し、接続数の増え方を O(N×M) から O(N+M) に近づけます。
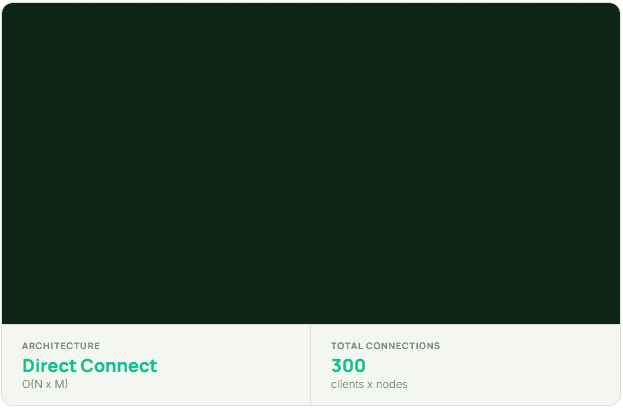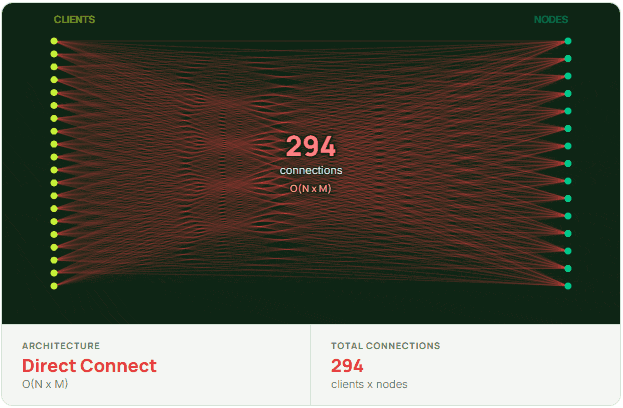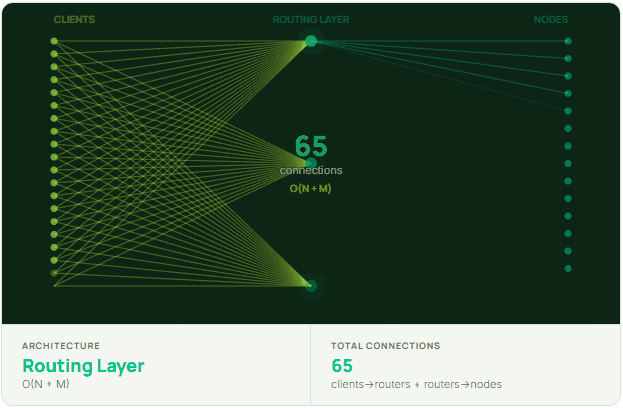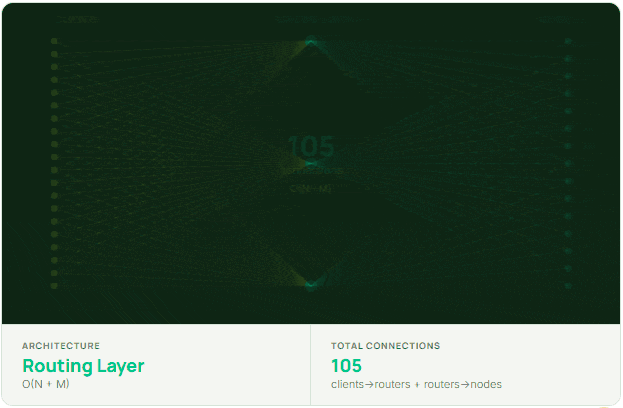
クライアントは少数のルーターに接続し、ルーターがクラスターへの安定した永続的な接続プールを維持します。Twitter が Twemproxy、Facebook が McRouter を開発したのはこのためです。解いていたのはキャッシュの問題ではなく、接続管理の問題でした。適切に実装すれば、ルーティング層が TLS ハンドシェイクを一度引き受け、その接続を数百万のリクエストで再利用し、バックエンドをデプロイ時のストームから守ります。実装が不十分なら、ボトルネックが 1 ホップ手前に移るだけです。ロックフリーのデータ構造、効率的なシリアライズ、正確なコンシステントハッシュなどの実装品質が、その違いを生みます。
三つ目は最も地味で、見落とされがちな対策です。接続数を後から考えるのではなく、主要な容量メトリクスとして扱います。NxM 問題を先回りするチームは、キャッシュ性能だけでなく、クライアント側の接続レート、メタデータ更新頻度、トポロジー変更の推定影響範囲を監視します。計画中のスケーリングで、30 秒間にクラスターへ届く接続試行が倍増するなら、デプロイ後ではなく開始前に知っておくべき情報です。
NxM はシステムが成長した証拠
NxM 問題は設計が悪い証拠ではありません。むしろ、接続のオーバーヘッドが重要になるほど大きくなった証拠です。
直接接続型アーキテクチャは、小規模から中規模では優れています。単純さは大きな利点です。クライアントはクラスターのトポロジー全体を把握でき、リクエストは最短経路を通り、理解や運用が必要な中間層もありません。その単純さの代償として、N と M が独立に増える状況への対応が難しくなります。
上記の緩和策は、どれも NxM を消すわけではありません。複雑さの置き場所を変えます。段階的なロールアウトではデプロイのオーケストレーションへ、ルーティングプロキシではルーティング層自体へ、接続レートの監視では容量計画へ移します。どこで問題を引き受け、どの運用範囲を自分たちで管理するかが、常にトレードオフになります。
Valkey によってより大きなクラスターが実用的になるにつれ、この種の挙動は実際の環境でさらに目立つようになります。数百ノードで頭打ちだったクラスターが、1,000 ノードを超えられるようになりました。メモリ容量とスループットには好ましいことですが、フリート内のすべてのクライアントに対し、NxM の式の M を増やすことにもなります。
この問題を理解すべき時期は、システムが影響を受けるほど大きくなる前です。接続数は容量計画モデルに含めるべきであり、日常的なトポロジー変更がレイテンシ障害に変わった午前 3 時のインシデントで初めて発見するものではありません。計算は簡単で、挙動も予測できます。問題の形を理解しているチームは、事後対応ではなく、設計によって対処できます。
メモリや CPU よりも先に接続負荷が制約になるシステムを運用してきた方には、なじみのある話でしょう。こうした障害のパターンこそ、運用知識の共有が役立ちます。デバッグの経緯もよく似ています。メトリクスは健全なのにクライアントは苦しみ、何を探すべきか分かって初めて根本原因が明らかになるのです。
Unlocked は、このような対話を広く共有するためのカンファレンスです。実務者が、接続負荷、ルーティングのトレードオフ、大規模な環境でレイテンシと信頼性を左右するアーキテクチャの判断について知見を交換します。まさにこうした課題に取り組むエンジニアに向けて、次回は今年 5 月に Seattle で開催されます。