社内キャッシュプラットフォームの台頭
Uber と Mercado Libre は分散キャッシュを毎秒数十億の操作へどう拡張したのでしょうか。プラットフォームを形作った接続ストーム、管理責任の課題、Valkey の選択を紹介します。
 Allen Helton
あるチームがレイテンシの改善に取り組んでいます。データベース呼び出しが少し遅い、あるいはトラフィックが増え、読み取り増幅の影響が出始めています。誰かが Valkey の追加を提案すると、すぐに効果が出ます。p99 は下がり、チームは次の仕事に進みます。
数か月後、別のチームが同じ問題に遭遇します。TTL、メモリ特性、許容できる障害が異なるため、キャッシュは共有したくありません。独自のクラスターを立ち上げると、それもうまく動きます。長い間、明らかな問題はありません。
ある日、キャッシュがいくつあり、誰が責任を持ち、半数が同時に劣化したら何が起こるのか、と問われます。答えは曖昧です。メトリクスは健全に見えます。インシデントはまれですが、なぜか説明が難しいものです。ストレージやネットワークの障害というより、連携の失敗に見えます。
この瞬間、キャッシュは単なる機能から重要なインフラに変わります。
キャッシュクラスターが予測できなくなるとき
小規模なキャッシュクラスターは、局所的な最適化です。大規模になると、コスト曲線、障害領域、デプロイ速度、チーム間の暗黙的な調整の量に影響し、システムそのものの形を決め始めます。
Unlocked では、Uber と Mercado Libre のエンジニアが、この移り変わりを内部から語りました。目立ったのは、同じプラットフォームを流れるワークロードの多様さです。
Uber は、約 2,000 のクラスター全体で、ピーク時に毎秒約 10 億の操作を処理しています。負荷の特徴はクラスターごとに異なります。オンラインデータインフラチームの Senior Staff Engineer、Yang Yang はこう述べました。「メモリ使用量は少なくても CPU を多用するものもあれば、非常に大きなメモリを使うものもあり、それぞれ課題が違います。」 ここまで多様になると、キャッシュは平均レイテンシの問題ではなく、レイテンシ分布の制御の問題になります。中央値だけでなく、曲線全体を範囲内に保つ必要があります。
Mercado Libre も、異なる構成で同様の圧力を受けています。Java、Go、Python、Node という四つの主要な言語スタックで数千のマイクロサービスを運用し、インフラは年に 30~60% 成長しています。Senior Principal Engineer の Ignacio Alvarez は使命を明快に語りました。「開発者が作るべきものに集中できるようにすることが、私たちの主な目的です。」 この成長率では、どの一つのチームにも全体が見えない意思決定の蓄積が、障害の要因になります。
どちらの環境でも、チームごとに一つのクラスターを持ち、各チームで管理する初期モデルが、劇的に破綻したわけではありません。次第に理解が難しくなったのです。書面では独立して見えた判断が、本番環境では、どのチームにも観測できない形で影響し合い始めました。
何かが壊れるのではなく、システムが不透明になっていきます。
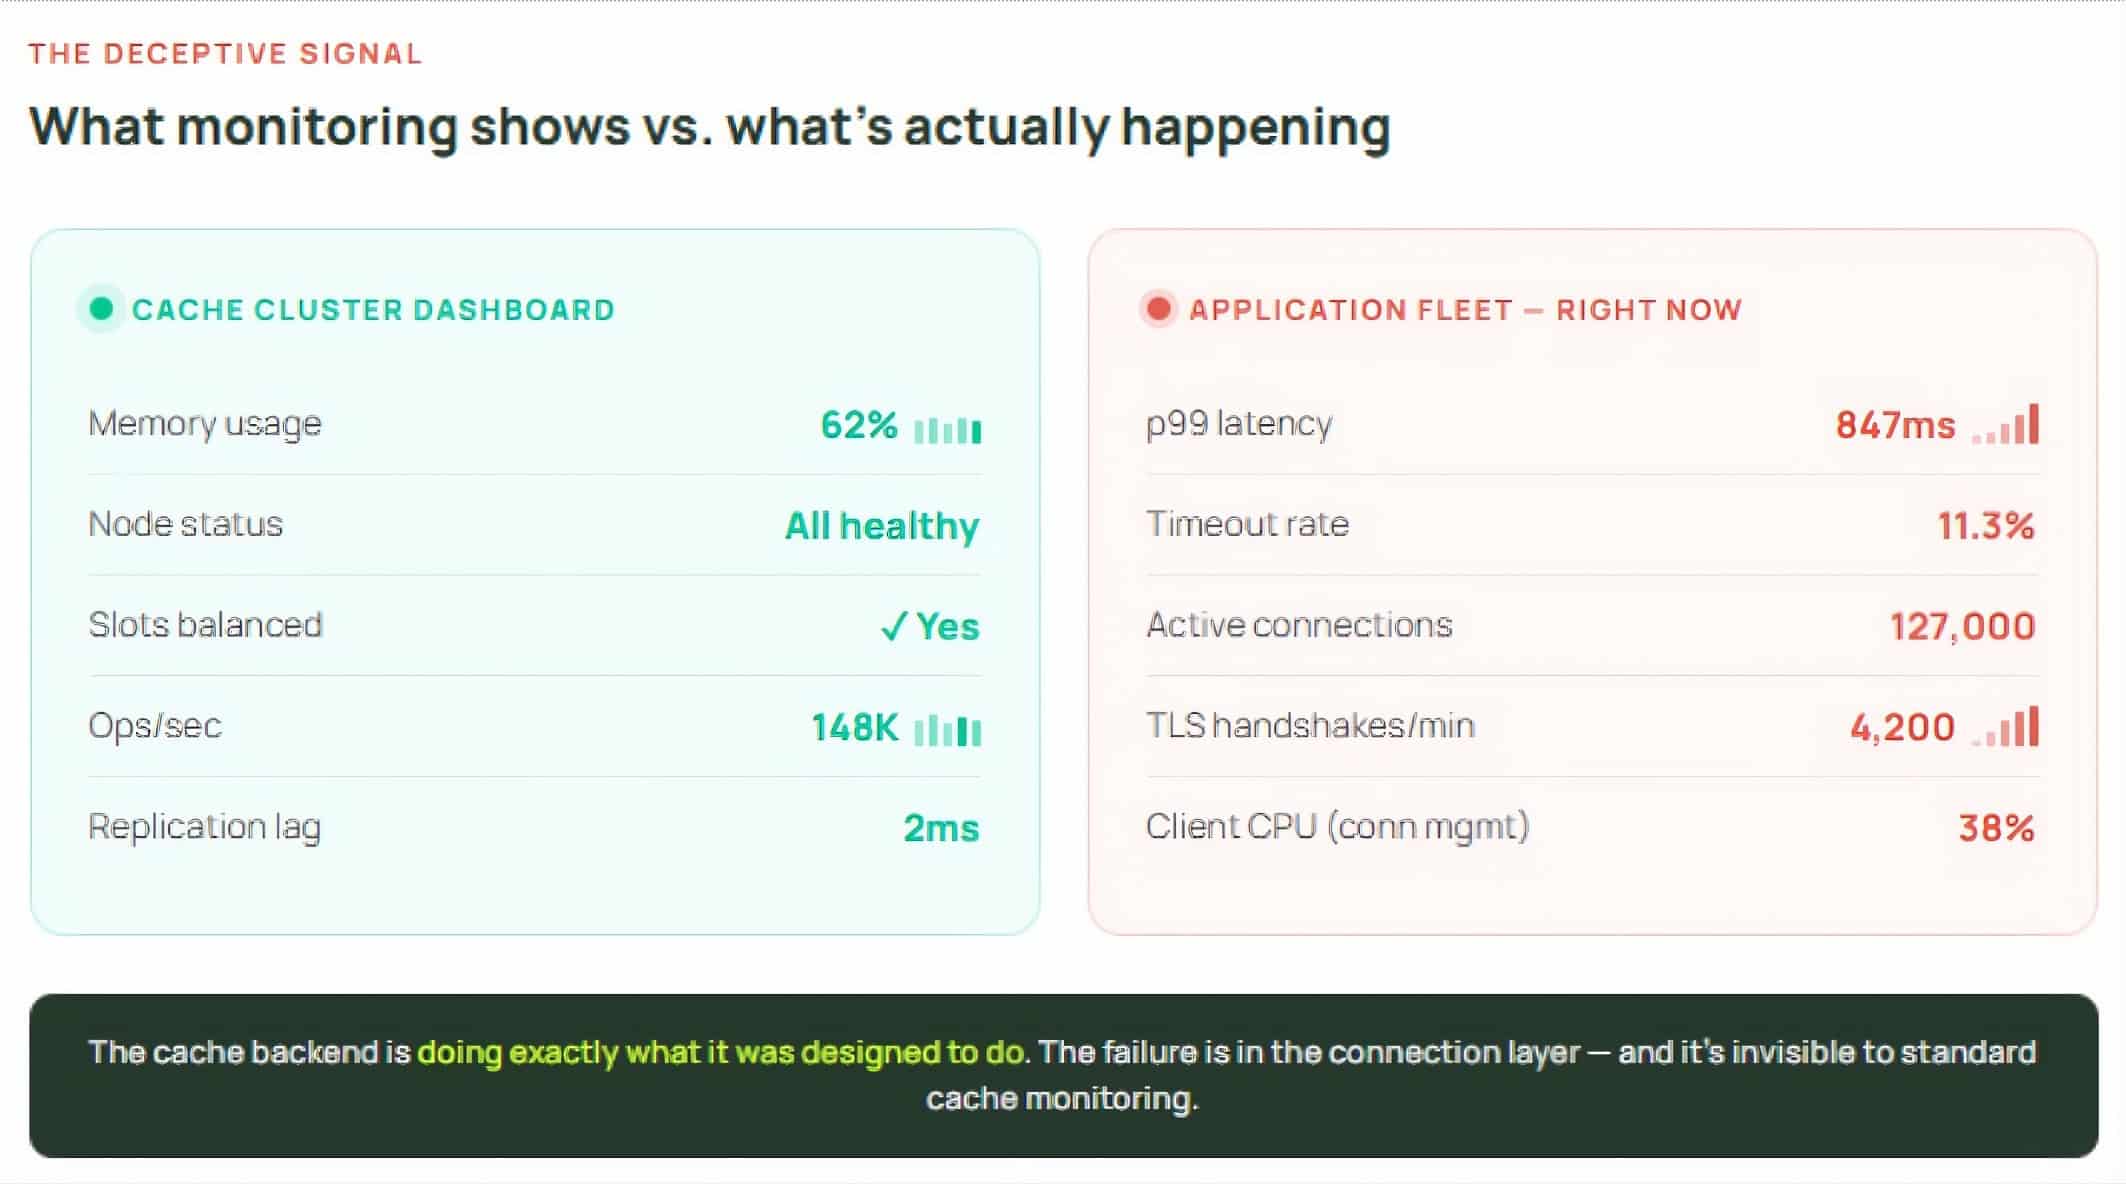
この不透明さが、プラットフォームを作るべき最初の兆候です。危機や事後検証ではなく、誰も明確に答えられない問いが徐々に積み重なることです。
技術より先に管理責任がボトルネックになる理由
両社が直面したのは、キャッシュの限界ではなく、管理責任の持ち方の限界でした。
プロビジョニングはセルフサービスで、ライフサイクル管理は非公式、分離は安全に思えます。しかし、ライフサイクルのイベントが同期すると、分離は見かけだけになります。独立したクラスターは、それぞれ独立した接続プール、リトライ、トポロジーへの反応を持ちます。再配置、ローリング再起動、アベイラビリティゾーンの事象などでインフラが変わると、それらの反応は意図せず同時に起きがちです。分離するための設計が、相関する挙動を生むのです。
Uber は、ライフサイクルの操作をコントロールプレーンの下に集約しました。プロビジョニング、スケーリング、修復、廃止を明示的なワークフローにしました。Staff Software Engineer の Shawn Wang は、*「すべての操作をワークフローで動かしています。スケーリングのチェックは毎日、自己修復は約 30 分ごとに実行します」*と説明しました。チームは必要なときにキャッシュを要求できますが、その運用負担はプラットフォームが引き受けます。
Mercado Libre は、逆の方向から似た解決策にたどり着きました。初期の構成は Memcached、アプリごとに専用クラスター、自由なクライアント選択でした。その結果、遊休インフラ、不適切なサイズ設定、利用のガバナンス不足が生じました。Redis を使い 2022 年に展開した第 2 世代では、ラッパー SDK、一元的なガバナンス、キーのプレフィックスによる透過的なマルチテナント化を導入しました。開発者が意識せずにクラスターを共有でき、プラットフォームチームはフリート全体の効率と影響範囲を管理できるようになりました。Alvarez はこう述べています。「利用者は意識していませんでしたが、異なる利用者で同じクラスターを共有できました。」
どちらも、プラットフォームチームが全体を見渡せるようになる変化は控えめなものでした。各チームは依然としていつキャッシュするかを選びます。プラットフォームは、全体のソリューションの一部としてキャッシュがどう振る舞うかを決めます。
接続ストームと帯域幅の上限が設計の問題をあぶり出す
両講演で特に示唆的だったのは、深刻なインシデントが、高負荷時のクライアントの挙動から始まり、キャッシュによって増幅されるケースの多さでした。
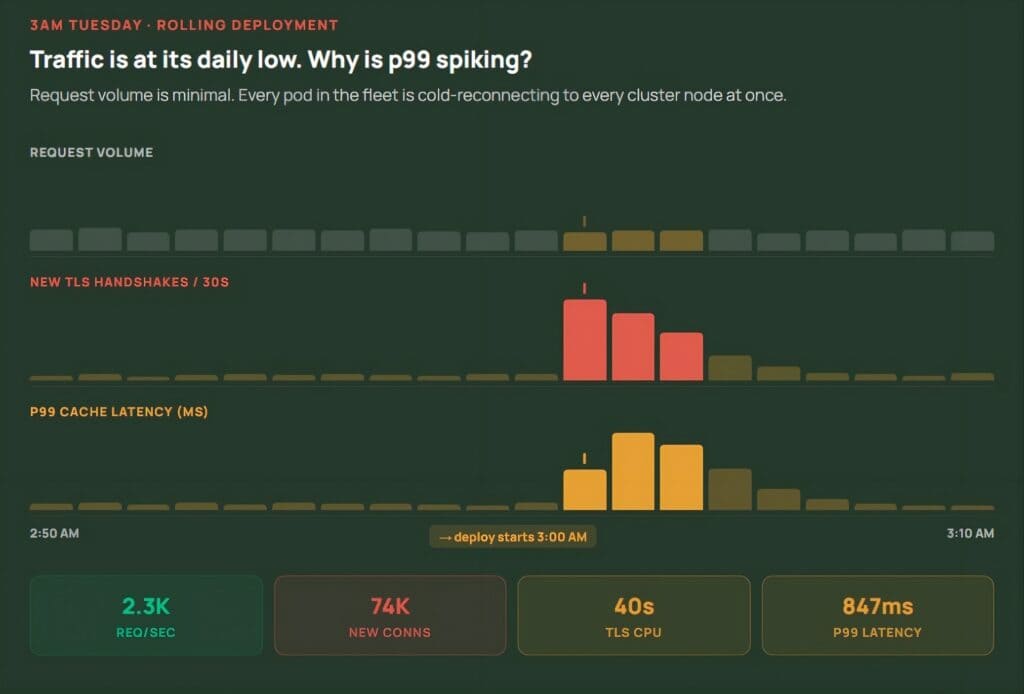
Uber は、社内の twin-proxy とスタンドアロン Redis を組み合わせた T-Redis から、ネイティブの Redis クラスターへの移行中に起きた障害パターンを紹介しました。ノードが遅くなるか短時間利用不能になると、Go Redis クライアントは接続を閉じ、すぐに新しい接続を開きました。Wang は、*「数百、数千のインスタンスで同時に起こると、リトライは負荷を和らげるどころか増幅します」*と説明しました。ノードの CPU は 100% に達し、応答が止まり、システム内で悪循環が生まれました。
その背後の接続数の計算は、単純で厳しいものです。n 個のサービスインスタンスが、各キャッシュノードに p 本の接続プールを維持するなら、そのノードが受けるのは n 本ではなく、n × p 本の接続です。
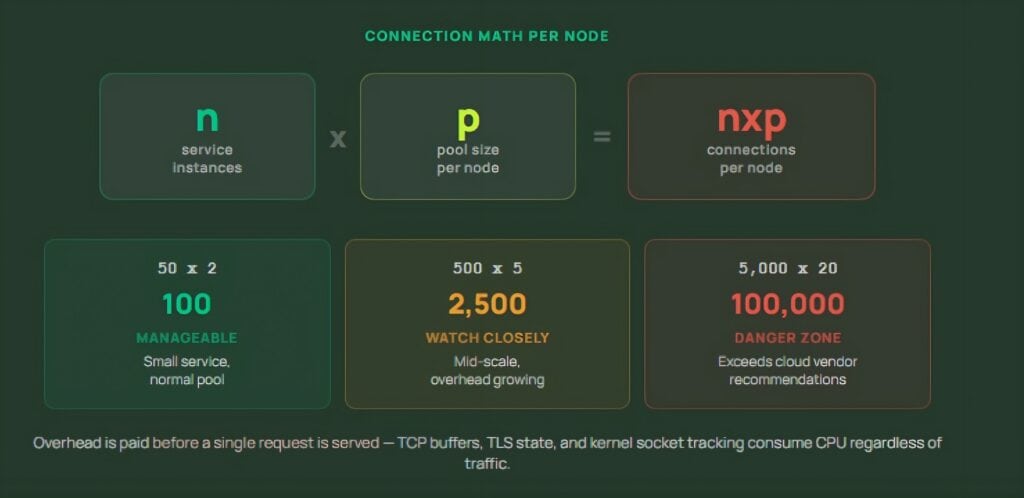
数千のインスタンスを持つ大規模サービスでは、リクエストを一件も処理する前に、ノードごとの接続が 100,000 本を超えます。TCP バッファーの確保、TLS 状態の追跡、カーネルのソケット管理によって、接続がアクティブかどうかに関係なく、オーバーヘッドだけで CPU とメモリを消費します。
Uber は複数の対策を重ねました。緊急時には iptables のルールで影響を受けたノードを隔離し、リトライによる負荷増幅の連鎖を止めました。長期的にはクライアントを更新し、過度な接続の破棄をなくし、新規リクエストの公平なキューイングと、アプリケーションの設定から独立した明示的な I/O タイムアウトを導入しました。また、ノード別のレートリミッターを備えたクライアント側のサーキットブレーカーを追加し、悪循環を先回りして抑えました。
この障害は、低トラフィックの時間帯に特に見誤りやすいものです。トラフィックが少ないからこそ夜間にデプロイしますが、ローリング再起動ではフリート内の全 Pod が全クラスターノードに一斉にコールド再接続します。接続ストームは、リクエスト数とは関係ありません。
Mercado Libre は、構造は異なっても同じくらい根本的な制約、帯域幅に直面しました。Alvarez はこう述べました。「効率とコストを最適化するとき、変数はたくさんあります。私たちのワークロードでは、帯域幅が主要なボトルネックで、最も多くの問題を引き起こしました。出入りするデータ量でノードが停止する問題が、最も解決困難でした。」 主な制約は毎秒のバイト数でした。リクエスト数ではなく、ペイロードサイズが障害になったのです。
どちらでも、キャッシュは設計どおりに動いていました。劣化の原因は、同期したクライアントの反応、大きすぎる値、フリート全体のリトライです。このパターンが現れたら、バックエンドの調整だけでは足りません。システムには、挙動を観測するだけでなく制御する場所が必要です。
ラッパー SDK とルーティング層が信頼性の基盤になる
ラッパー SDK とルーティング層は、開発体験を便利にするものと誤解されがちです。大規模な環境では、チームが自発的に正しい振る舞いへ収束することを期待する代わりに、プラットフォームがその振る舞いを強制する仕組みになります。
Uber のクライアントライブラリは、数百のマイクロサービス全体で、リトライのセマンティクス、コネクションプーリング、サーキットブレーカー、バッチ処理、オブザーバビリティを標準化しました。ラッパーにより、部分障害の際に負荷を増幅する過度なリトライを、個別のチームが設定しにくくしました。Go には Go-Redis、Java には Lettuce を標準とし、その上に薄いラッパーを構築しました。クラスター検出を抽象化し、メトリクスを組み込み、サーキットブレーカーとコンテキスト伝播を利用できます。Lettuce の I/O 多重化は特に注目され、Go クライアントにも同等の機能を検討し始めました。
Mercado Libre の SDK は、バックエンドの選択そのものを抽象化しました。開発者は Memcached か Redis かを選ばず、機能を使うだけです。その抽象化の中に、プラットフォームチームは任意で有効化できる圧縮コーデックを追加しました。アプリケーションを書き換えずにペイロードを小さくし、一行のコードにも触れず、プラットフォーム層で帯域幅の問題に直接対応しました。動的なスケーリング、コンピュート種別の選択、条件に応じたインフラ切り替えなどの効率化も、すべて開発者に意識させず実装しました。
この抽象化の目的は、システム全体の挙動を制御可能にすることです。接続ストームが形成される前に防ぎ、ホットキーへのバーストが集中する前に吸収し、タイムアウトの挙動がフリート全体に連鎖する前に標準化できます。社内キャッシュプラットフォームは、クライアントがクラスターとどうやり取りするかを統制する制御点の集合になります。
大規模なチームが Valkey に移る理由
両社は Valkey への移行についても語りました。その動機は示唆的です。最低のレイテンシを追い求めたのではなく、長期的な存続と運用の継続性を重視していました。
Yang Yang は評価基準をこう説明しました。「性能、クライアントの能力、アップグレードの複雑さ、コントロールプレーンとの互換性、長期的な持続可能性が基準です。Valkey はこれらをよく満たしています。高負荷時にも安定したレイテンシ、強いクライアント互換性、管理しやすい更新経路、私たちのコントロールプレーンとの互換性、そして参加したいと思える成長中のコミュニティがあります。」 Mercado Libre も Redis のライセンス変更を受けて同じ方向に進みました。既に作っていた抽象化層のおかげで、移行の大部分をアプリケーションチームに意識させずに済みました。Alvarez は簡潔に、*「Valkey が登場しました。Valkey が大好きです」*と語りました。
これは、Valkey を直接運用せず、マネージドなプラットフォームを通じて利用する構造的な利点の一つです。データストアが独自 SDK や Momento のようなサービスの抽象化層の背後にあれば、バックエンドの移行はアプリケーションの書き換えではなく、運用上の判断になります。移行はプラットフォームが引き受け、各チームは開発を続けられます。Momento もまさにこの方法を取っています。私たちは Valkey を、大きな負荷の下で運用しています。ルーティング層、接続管理、ホットキーの吸収、マルチテナントの分離は既に組み込まれています。利用するチームは、運用範囲を引き受けずに、十分に調整された Valkey 環境の性能を得られます。
キャッシュが基盤インフラになると、判断の時間軸も変わります。四半期ごとの性能向上より、数年単位の安定性を重視するようになります。データストアは、システムの継続性を支える契約の一部になります。興味深いのは移行そのものではなく、プラットフォームチームがリリース単位ではなく年単位で考え始めることです。可視性の意味も変わります。個々のアプリケーションチームではなく、プラットフォームがキャッシュフリート全体の健全性に責任を持ちます。
社内キャッシュプラットフォームを構築すべき段階を見極める
社内キャッシュプラットフォームの登場は、劇的な転換であることはまれです。エンジニアが何に時間を使い、何を心配するかが徐々に変わります。それを早く認識できるかが、意図的に構築するか、連鎖障害への対応に追われるかを分けます。
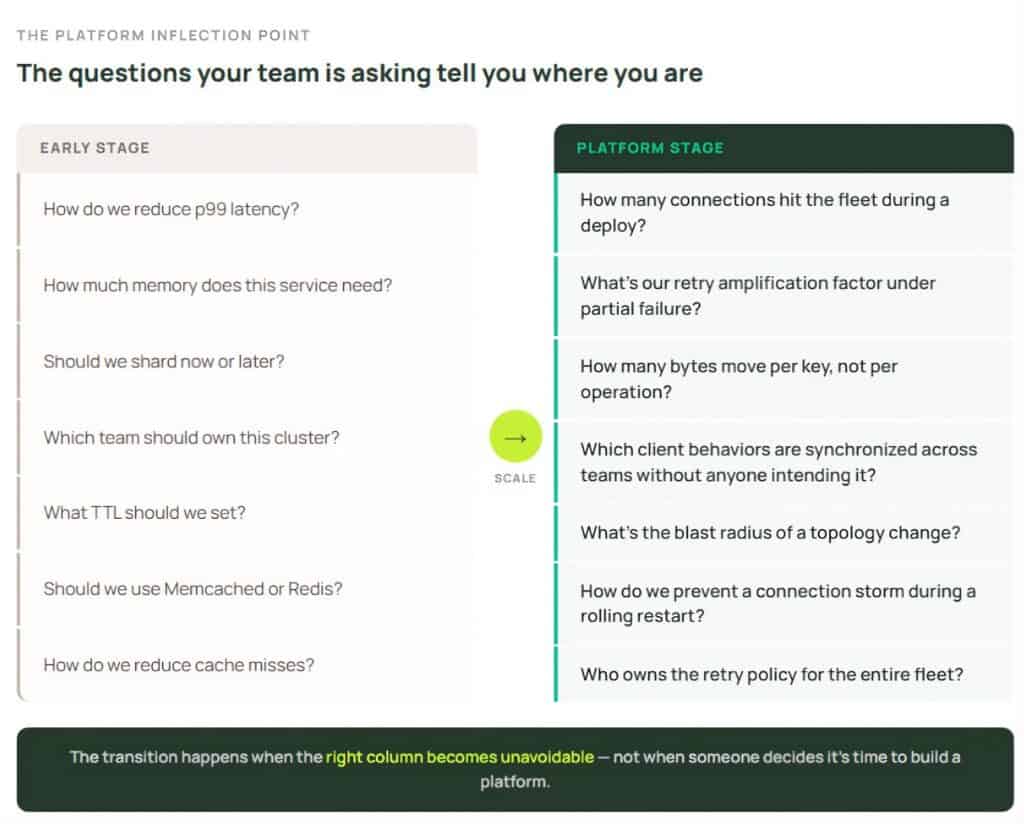
図の右側にある課題を避けられなくなったとき、この移行が起きます。キャッシュを独立したチーム所有の資源として扱い続けるコストが、一元管理に必要な調整層を構築するコストを上回るのです。Uber と Mercado Libre は、この転換を、摩擦が徐々に積み重なって最後には避けられなくなったものとは説明していませんでした。
Unlocked の講演が共感を呼んだのは、エンジニアたちが機能一覧ではなく、perf のトレース、接続数の計算、ペイロードの分布を比較していたからです。分野が違っても、流れは同じでした。キャッシュは性能最適化として始まり、連携の問題になり、組織はその問題を偶然ではなく意図的に解くため、社内キャッシュプラットフォームを作ります。
本記事で紹介した対話は、性能が重要なキャッシュインフラに取り組むエンジニア向けのイベント、Unlocked で行われました。次回は 今年 5 月に Seattle で開催されます。チームが成長後の段階の問いに向き合っているなら、こうした対話が行われる場所にぜひお越しください。 詳細と参加登録 →