分離構成が KV キャッシュをシステムの基本要素に変える
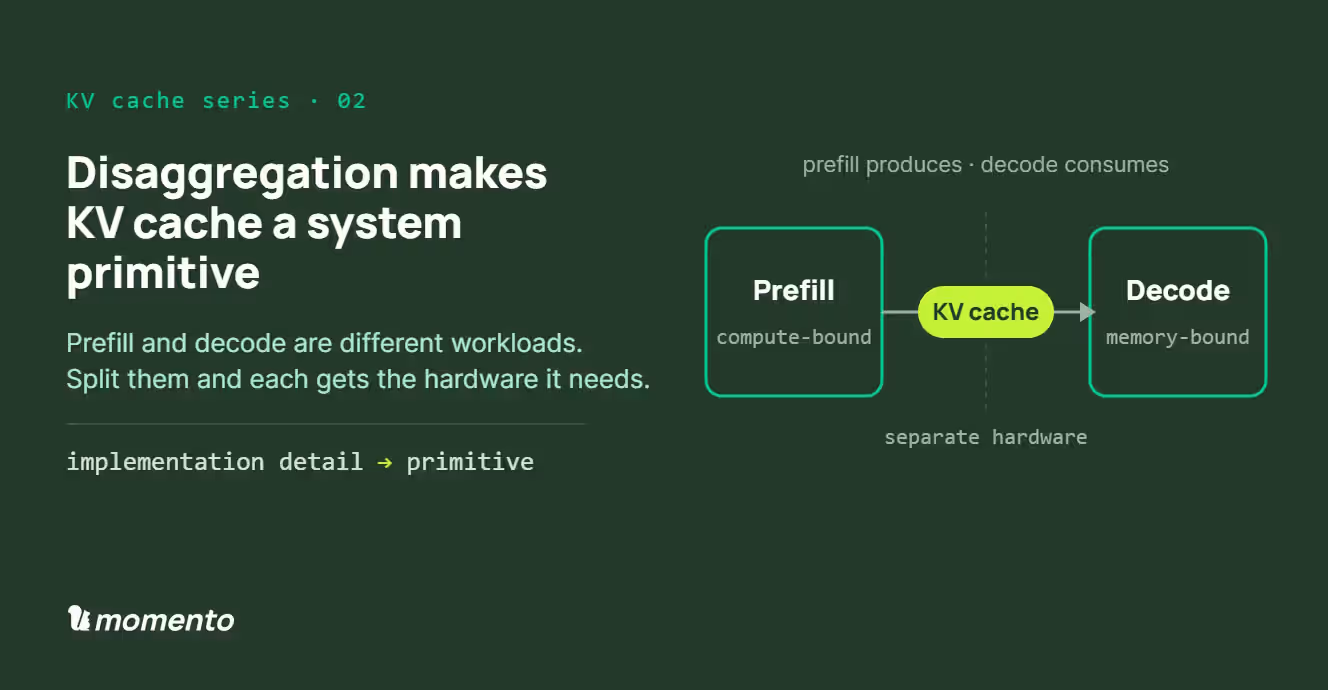
プリフィルとデコードは異なるハードウェアを求めます。分離すると KV キャッシュは両者をつなぐ状態となり、実装の詳細からシステム設計の課題へと変わります。
 Khawaja Shams
推論の規模拡大は、それを提供するアーキテクチャの進化を上回っています。プリフィルとデコードは1つのパイプラインとして扱われがちですが、本質的に異なるワークロードです。
プリフィルは計算負荷が高く、演算密度はデコードより1桁高くなります。デコードはメモリ帯域幅とレイテンシに敏感です。プリフィルが求めるのは FLOPS の高いアクセラレーターで、デコードが求めるのは大容量で高速なメモリです。両方を同じ GPU に載せると、一方に合わせて調整した GPU が他方も処理することになり、負荷が高まるとプリフィルがデコードを妨げます。どちらの段階も、最適なハードウェアを使えません。
キャッシュが接続を担う
分離構成では、この2つの段階を切り離します。プリフィルノードはプリフィル、デコードノードはデコードを、それぞれのボトルネックに合ったハードウェアで実行します。
分離によって干渉はなくなりますが、間に隔たりができます。1つのアクセラレーター内なら、プリフィルからデコードへ直接進み、中間状態がチップの外へ出ることはありません。別々のマシンへ分けると、その状態、つまり KV キャッシュを受け渡す必要が生じます。プリフィルが生成し、デコードが消費する。分離によって KV キャッシュは両者をつなぐオブジェクトになります。
単一ノードでは、KV キャッシュはほぼ推論エンジンが管理する実装の詳細です。しかしプリフィルとデコードが別システムになると、キャッシュは両者の接続を担い、すべてのリクエストがその受け渡しに依存します。
分離がキャッシュに求めるもの
マシン間を移動する必要が生じると、キャッシュにも分散システム内を移動するオブジェクトと同じ要件が課されます。
キャッシュはプリフィルノードからデコードノードへ移動するため、転送レイテンシ、シリアライズ形式、ネットワーク帯域幅が中心的な課題になります。適切な場所へ届く必要があるため、どのデコードノードがどのキャッシュを受け取るかというルーティングは、スケジューリングの問題になります。失効も必要であり、誰がいつエントリを追い出すのかが問われます。同居構成ではエンジンが処理していた仕事に、連携が必要になるのです。また GPU メモリ、ホストメモリ、NVMe、リモートストレージのいずれかに置く必要があり、各階層でレイテンシと容量のトレードオフが異なります。
これは、ストレージと計算を分離するたびに現れる分散システムの問題です。同じ場所にあったものが独立してアドレス指定できるようになり、転送層で結ばれます。配置、ルーティング、退避、階層型ストレージといった解決手法は、よく理解されています。新しいのは、それらを推論サービング内の KV キャッシュに適用することです。
実装の詳細からシステム設計へ
主要な推論基盤は、すでにこの分離を前提として構築されています。NVIDIA Dynamo は、分離型推論を、プリフィルエンジンがプリフィルを計算して KV キャッシュを生成し、それをデコードエンジンへ渡し、デコードエンジンがデコード段階を実行する構成と説明しています。AWS もインフラにこの分離を取り込み、計算負荷の高いプリフィルには Trainium を用いています。Cerebras との提携も同じ方向を示していると考えられます。ウェハースケールの SRAM は、メモリ制約のあるデコードに向いているためです。
どの構成でも、階層間で受け渡すのは KV キャッシュです。単一ノードでは、実行、無効化、調整が可能な最適化にすぎず、アーキテクチャは意識する必要がありませんでした。分離によって同じ問題が1段上がり、エンジンに隠されていた実装の詳細から、アーキテクチャが責任を持つシステム設計の課題になります。キャッシュをマシン間で転送、ルーティング、保存、失効させる必要が生じ、システム全体がプリフィルからデコードへの受け渡しを中心に構築されます。
単一リクエスト内の一時的な状態として始まったものが、2つのシステムをつなぐ受け渡しになります。その受け渡しが生まれた時点で、キャッシュ管理はアーキテクチャの第一級の基本要素になるのです。