大規模な KV キャッシュオフロードのロードマップ
巨大化する KV キャッシュに GPU の HBM 拡張は追いつきません。ローカル、ピアツーピア、リモート永続ストレージという三つの成熟段階を紹介します。
 Tony Valderrama
今日、KV キャッシュの巨大さそのものが、大規模な推論にとって大きな問題になっています。
コンテキストウィンドウの長大化、複数ターンのセッション、そして推論状態を一時的ではなく持続的なものとして扱うエージェントのワークロードにより、KV キャッシュは爆発的に増えています。GPU の HBM は、その増加に追いつく速さで容量を拡大できません。sglang や vLLM などの推論エンジンで広く採用されるようになった解決策は、KV キャッシュをオフロードして圧力を軽減することです。
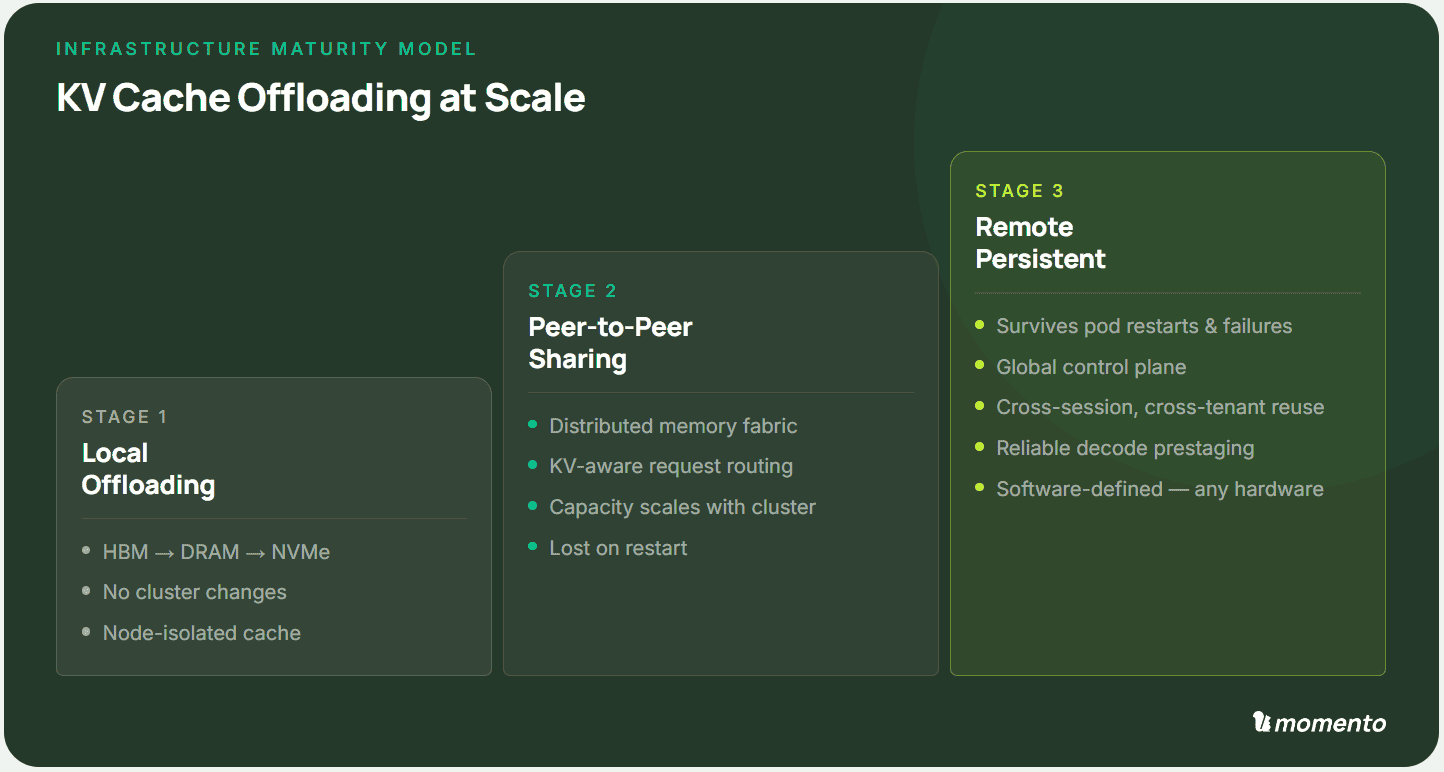
KV ブロックを GPU から遠くへ移すほど、レイテンシ、スループット、コストについて複雑な検討が必要になります。ただし技術上の課題は、オフロードするかどうかではなく、どこまで遠くへ、どの程度の連携の下で行うかです。ここでは、推論スタックを段階的に進化させる指針として、KV キャッシュの成熟度を三つの段階で示します。
第 1 段階:ローカルへのオフロード
最初の段階では、追い出したブロックを同じ物理ホストへ退避し、HBM の外へ KV 容量を広げます。継続的な同時処理によって HBM がいっぱいになると、ランタイムはブロックをホストの DRAM に退避します。DRAM が埋まると、さらにローカル接続の NVMe ストレージへ移します。プリフェッチでは逆に、デコード段階に先立ってブロックを GPU に近い側へ戻しておきます。
この手法は、標準的なファイルシステムインターフェースを通じたノード内のアクセス経路を使います。クラスターのネットワーク、ルーティングのインフラ、推論ランタイムの設定変更は不要です。既存のハードウェアに、最小限の運用リスクで導入できます。
効果は確かです。ノードごとの実効 KV 容量は桁違いに増えます。本来なら追い出されて再計算されるウォームなコンテキストを、引き続き利用できます。単一ノードの環境や、短いコンテキストウィンドウを扱う小規模なフリートでは、この単純な組み込み機能だけで十分なこともあります。
ただし限界も明確です。テラバイト単位のローカルキャッシュでも、時間がたてば埋まります。各ノードのキャッシュは、クラスターの他のノードから見えません。同じ文書を 10 人のユーザーが取り込み、10 台の異なるマシンに送られると、各ノードが同じ KV ブロックを独立に計算してキャッシュします。フリートが増えるほど、ノードごとのヒット率は下がり、重複したプリフィルに費やす無駄な計算も増えます。
第 2 段階:ピアツーピア共有
第 2 段階では、クラスター全体のメモリを一つの共有資源として扱います。各ノードが孤立したキャッシュを持つ代わりに、分散メモリ基盤が全ノードの KV ブロックを同時に公開します。どのノードに保存されているかに関係なく、どのインスタンスも別の場所で計算したブロックを読めます。
ピアツーピアのキャッシュをうまく機能させるには、二つの要素が必要です。一つ目は最適化されたデータ転送層です。PCIe や RDMA などの高速インターコネクトはもちろん有効ですが、ネットワークスタックを最適化すれば、一般的なデータセンターの TCP ネットワークでも優れた性能を実現できます。ゼロコピー転送、高い並行性を持つスレッド処理、リアルタイム圧縮、パイプライン化、バッファーの調整といった実装の詳細に注目してください。
二つ目は、リクエストルーターがキャッシュ状態を理解することです。KV の局所性を無視するルーターは、関連するブロックをまったく持たないノードへ頻繁にリクエストを送ります。適切に振り分ければキャッシュにヒットできたのに、プリフィルの全コストを払うことになります。KV を認識するゲートウェイは、候補となる各ノードで各リクエストを処理するプリフィルコストを推定し、それに基づいてルーティングします。
二つが連携すると、結果は大きく変わります。キャッシュ容量はクラスターの規模に比例して増えます。転送層がブロックをすばやく移動させるため、長いコンテキストのワークロードでは、ノードをまたぐヒットのレイテンシが GPU 上のキャッシュに近づきます。スケールアウトによるスループットの向上は頭打ちにならず、積み重なります。
残る制約は永続性です。この共有メモリ基盤は RAM とローカルディスク上にあります。ノードを一つ再起動するだけでも、クラスター全体の記憶に穴が開きます。クラスターを再起動すれば、キャッシュしたコンテキストはすべて失われます。複数のセッションにまたがるワークロードには、根本的な不足です。前のセッションのキャッシュ済みコンテキストを頼るエージェントシステムは、プールに何も見つからず、一から再計算しなければなりません。
第 3 段階:リモートの永続ストレージ
最後の第 3 段階では、KV キャッシュに永続性を持たせ、能動的に管理します。ブロックをメモリにしか存在しない揮発性オブジェクトとして扱わず、Pod の再起動、ノード更新、クラスター全体の障害にも耐える共有ストレージに保存します。あるセッションで蓄積したコンテキストを、次のセッションで再利用できます。
アーキテクチャは大きく変わります。KV データは、GPU メモリともローカルディスクとも独立したストレージ種別として管理されます。各ブロックをどこに置き、いつ追い出し、どのように GPU 側へ事前配置するかは、プラットフォームレベルのオーケストレーションが担います。こうした判断を推論ランタイムから切り離し、専用のグローバルなコントロールプレーンへ移します。
実装上の重要な問いの一つは、全体で調整されたグローバルキャッシュを活用するために、専用ハードウェアが必要かどうかです。独自アクセラレーターや特殊なネットワーク機器は優れた基礎性能を発揮しますが、高価で、供給が限られ、特定のベンダーのエコシステムに運用者を縛ります。
幸い、私たちのテストでは、標準的なクラウドサーバーとネットワーク向けに最適化した、完全にソフトウェアで定義されるアーキテクチャで十分だと実証できました。あらゆるハードウェアへすばやく展開でき、柔軟でリスクの低い方法を取れます。
リモートの永続ストレージと能動的なオーケストレーションがそろうと、フリート全体で効果が積み重なります。複数のセッション、複数のノードにまたがる再利用が通常の動作となり、確実な事前配置によってデコードの停止をなくせます。
どこから始めるか
この成熟度モデルの各段階は、互いに排他的なフェーズではありません。複雑さ、コスト、能力のトレードオフ曲線上にある、異なる点を示します。
少数のノードで短いコンテキストを扱う小規模なフリートなら、ローカルキャッシュで十分です。多数の同時ユーザー間でプレフィックスの再利用が多い中規模環境には、共有 P2P メモリプールが有効です。セッション、テナント、デプロイをまたいでエージェントのワークロードを動かす大規模なフリートには、グローバルなキャッシュオーケストレーションが提供する高度な永続性が必要になります。
KV キャッシュ管理は、推論エンジン内部の実装詳細から、ネットワーク、ストレージ、オーケストレーションにまたがる分野へと進化しました。このモデルは、小さな段階的投資で各段階の新しい能力を得られるよう、明確な道筋を示すものです。推論が進化する以上、インフラも進化しなければなりません。
Momento は、効率的なハイパースケールキャッシュを通じて、AI の次の領域を実現していきます。ブログで取り組みをご覧いただくか、新しいアイデアの検証で協力したい方はぜひご連絡ください。