継続が成果を生む:Valkey が200 Gbpsに至るまで
4つのリリースにわたる I/O スレッドの改善が、直列コピーのボトルネックを解消し、p99 レイテンシを削減。200 Gbps の検証環境で、大きな GET が回線速度に達しました。
 Khawaja Shams
整合性モデルについての記事を期待して来た方には、申し訳ありません。今日お話ししたいのは、人生における継続の価値です。努力は足し算ですが、継続は掛け算です。
ここ数年、Valkey が構想から、コミュニティ主導で刺激を与えるプロジェクトへ成長する姿を見られたことを光栄に思います。各リリースで、メモリ効率、大規模環境の可用性、大幅な性能向上まで、着実に改善されています。小さな改善が積み重なって、大きな効果になります。
この相乗効果と意欲あるコミュニティの力を最もよく示すのは、I/O スレッドのアーキテクチャの進化と、1 MB〜64 MBの大きなオブジェクトへの影響かもしれません。大きなデータは、推論の KV キャッシュ、4K 動画配信など、魅力的な用途でますます重要になっています。少なくとも、大きなオブジェクトが他のリクエストのレイテンシにも影響することは見逃せません。本記事では、大きなオブジェクト自体の処理速度を測ります。
ここから、興味深い結果を見ていきましょう。
I/O スレッドの簡単な歴史
Valkey 7.2 は、可能な限りシングルスレッドを維持しようとするソフトウェアから I/O スレッドモデルを受け継ぎました。メインスレッドと I/O スレッドは、同期バリアで区切られた段階ごとに協調して動きます。7.2の設定ファイルにも、「通常、読み取りのスレッド化はあまり役立たない」と率直に書かれています。
Valkey 8.0 は I/O スレッドを根本から再設計し、スループットを3倍、毎秒100万リクエスト超へ高めました。この発想は新しくありません。フォークの7か月前、2023年8月に Dan Touitou が redis#12489 を提出し、ベンチマークを含め、まさにこの設計を詳しく示していました。
Redis は #12489 を放置しました。現在も未割り当て、マイルストーンなしのまま、トラッカーで未解決になっています。
フォークから数日で、Valkey コミュニティは提案をそのまま issue #22 へ移し、「真の宝石」と歓迎して実装しました。新アーキテクチャでは、キューでつながる I/O スレッドが継続して動き、メインスレッドがコマンドを実行する間も、別のコアで読み取り、解析、書き込みが進みます。Valkey 8.1 は #1338 で TLS ハンドシェイクを I/O スレッドへオフロードしました。
Redis はフォークの1年後、自身のトラッカーへの提案から21か月後の2025年5月、Redis 8で非常によく似た非同期 I/O スレッドモデルを提供しました。同じ頃、私たちは小さなオブジェクトで Valkey 8.1 と Redis 8.0 を直接比較しました。Valkey 8.1 は書き込みで37%、読み取りで16%上回りました。
Valkey 9.0 は応答コピーの回避を導入し、大きなデータの性能を一変させました。それまでは、メインスレッドがオブジェクト全体を接続の応答バッファへコピーしてから、次のコマンドへ進んでいました。大きなデータをコピーしている間、パイプライン全体が止まり、小さなオブジェクトも完了まで処理されません。
Valkey 9.0 は代わりに I/O スレッドへ参照を渡し、参照カウントでオブジェクトを保持します。接続の I/O ワーカーが、オブジェクトのメモリを直接 writev() へ渡します。これで I/O スレッドへの受け渡しが短くなり、メインスレッドはリクエスト処理へ戻れます。
Valkey 9.1 では、メインスレッドと I/O スレッド間の通信をロックフリーキュー中心に再設計しました。リリースノートでは、これによる8〜17%のスループット向上が報告されています。
これらから、8.0では小さなデータの読み書きが伸びても、大きなデータではネットワークを使い切れないと予想しました。9.0では GET が回線速度に達し、9.1では書き込みが改善すると考えました。
オープンソースの競争は、Redis を使い続けるチームにも、この恩恵をもたらします。7か月間未割り当てで放置されていた性能設計が、提案から2年以内に両プロジェクトの標準になりました。
数値で確認する
200 Gbps で接続した2ノード上で、Valkey の4リリースについて、値サイズを1 MB〜64 MBに変えて測定しました。詳しい構成は後述します。
Valkey 7.2:読み取りは35 Gbps、書き込みは55 Gbpsが上限

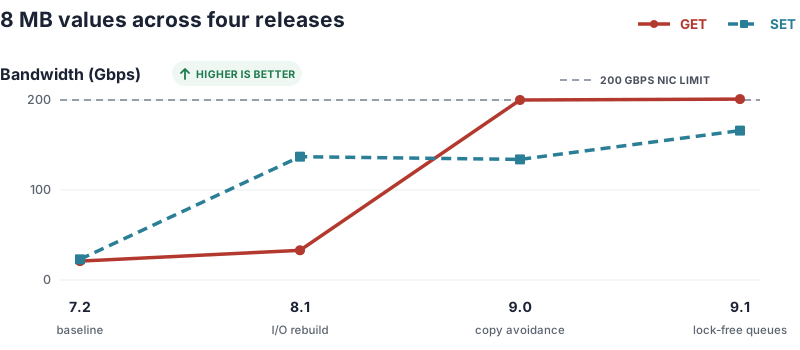
8 MBの値では読み取り21 Gbps、書き込み23 Gbpsで、p99 レイテンシはそれぞれ174 ms、164 msです。io-threads-do-reads を有効にして変わったのは、1 MBの読み取りだけでした。
Valkey 8.0 と8.1:書き込みは飛躍、大きな読み取りは横ばい

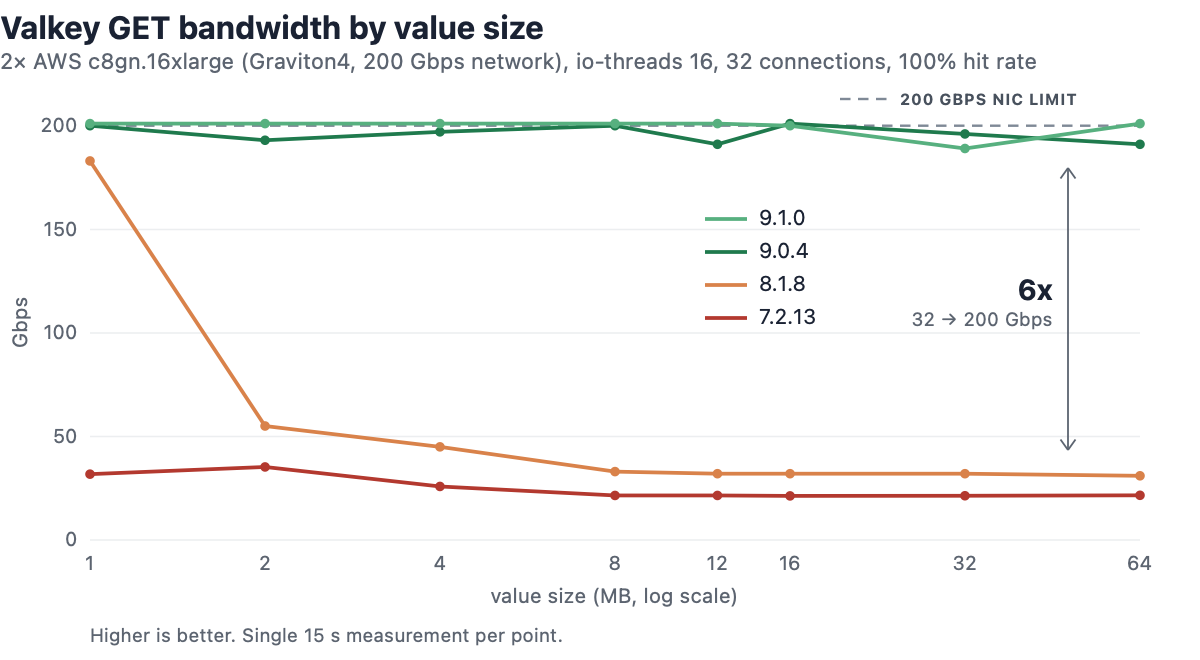
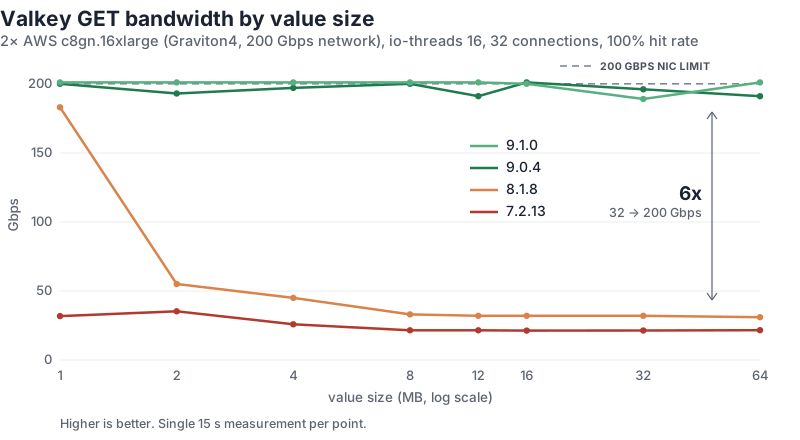
スレッドの再設計により、8 MBの書き込みは23から137 Gbpsへ6倍になり、1 MBの読み取りは183 Gbpsに達します。一方、大きな読み取りは8 MBでも64 MBでも30〜33 Gbpsにとどまります。この横ばいは、バイトごとの直列処理がボトルネックであることを示唆します。Valkey 8.0.9 と8.1.8は全サイズで同じ結果だったため、1本の線で両方を表しています。
Valkey 9.0:大きな GET が回線速度へ

1 MB〜64 MBのすべてのサイズで、読み取りが190〜201 Gbpsになります。8 MBの p99 は112から24 msへ、64 MBは1秒弱から230 msへ下がります。取り込み経路はもともとコピーが制約ではなかったため、書き込みは変わりません。その上限が変わるのは9.1です。
Valkey 9.1:書き込みにも余裕が生まれる

読み取りがネットワークの上限に達した一方、改善は書き込みに現れます。8 MBの書き込みは134から166 Gbpsへ24%増え、12 MB〜64 MBでも11〜19%増えます。
短時間の結果は長時間でも続いた
15秒の測定が偶然よい時間帯を捉えただけではないと確かめるため、8 MBの GET と SET のすべての測定を15分間でやり直しました。Valkey 9.1 がよい例です。GET は200.8 Gbps、SET は165.5 Gbpsを維持し、元の201、166 Gbpsと一致しました。時間がたっても低下はありませんでした。

詳細結果
読み取り(GET)
GET のみ、32接続、ヒット率100%。
GET 帯域幅(Gbps)
| 値のサイズ | 7.2.13 | 8.1.8 | 9.0.4 |
|---|---|---|---|
| 1 MB | 32 | 183 | 200 |
| 2 MB | 35 | 55 | 193 |
| 4 MB | 26 | 45 | 197 |
| 8 MB | 21 | 33 | 200 |
| 12 MB | 21 | 32 | 191 |
| 16 MB | 21 | 32 | 201 |
| 32 MB | 21 | 32 | 196 |
| 64 MB | 22 | 31 | 191 |
Valkey 9.1の読み取りも回線速度を維持するため、表は9.0までとしています。
GET p99 レイテンシ(ms)
| 値のサイズ | 7.2.13 | 8.1.8 | 9.0.4 |
|---|---|---|---|
| 1 MB | 13 | 2.2 | 2.4 |
| 2 MB | 20 | 19 | 5.1 |
| 4 MB | 58 | 41 | 9.4 |
| 8 MB | 174 | 112 | 24 |
| 12 MB | 244 | 166 | 56 |
| 16 MB | 329 | 238 | 56 |
| 32 MB | 531 | 489 | 116 |
| 64 MB | 948 | 1,020 | 230 |
書き込み(SET)
SET のみ、32接続。
SET 帯域幅(Gbps)
| 値のサイズ | 7.2.13 | 8.1.8 | 9.0.4 | 9.1.0 |
|---|---|---|---|---|
| 1 MB | 51 | 201 | 201 | 201 |
| 2 MB | 53 | 200 | 200 | 201 |
| 4 MB | 55 | 200 | 200 | 201 |
| 8 MB | 23 | 137 | 134 | 166 |
| 12 MB | 23 | 135 | 139 | 166 |
| 16 MB | 24 | 137 | 139 | 165 |
| 32 MB | 24 | 139 | 134 | 159 |
| 64 MB | 24 | 130 | 134 | 149 |
SET p99 レイテンシ(ms)
| 値のサイズ | 7.2.13 | 8.1.8 | 9.0.4 | 9.1.0 |
|---|---|---|---|---|
| 1 MB | 8.7 | 3.3 | 3.2 | 3.2 |
| 2 MB | 17 | 6.5 | 6.7 | 5.3 |
| 4 MB | 35 | 12 | 13 | 14 |
| 8 MB | 164 | 41 | 49 | 34 |
| 12 MB | 289 | 62 | 57 | 52 |
| 16 MB | 357 | 77 | 70 | 60 |
| 32 MB | 1,580 | 118 | 143 | 107 |
| 64 MB | 2,580 | 237 | 213 | 206 |
検証構成
マシン。 同じアベイラビリティーゾーンとクラスタープレイスメントグループに置いた、Graviton4 と200 Gbpsネットワークを持つ c8gn.16xlarge 2台です。Amazon Linux 2023で動作します。
サーバー。 公式 valkey/valkey Docker イメージの 7.2.13、8.1.8、9.0.4、9.1.0 を検証しました。8.0.9 も測定しましたが、全サイズで 8.1.8 と実行ごとの誤差の範囲で一致したため、表の8.x列には8.1を使っています。Valkey 7.2も新版と同じフラグで実行しました。対照試験で io-threads-do-reads yes にすると、1 MB GET だけが32から41 Gbpsへ変化しました。各版をホストネットワークの新しいコンテナで実行しました。
docker run --network host --cpuset-cpus 8-23 \
  --ulimit nofile=32768:65536 valkey/valkey:<version> \
  --save '' --appendonly no --io-threads 16 \
  --protected-mode no --maxmemory 60gb
永続化は無効です。Valkey の io-threads の16スレッドは、メイン1本と I/O ワーカー15本です。プロセスをコア8〜23へ固定し、ネットワーク割り込みを処理するコアでカーネルと競合しないようにしました。
割り込み。 両マシンで irqbalance を停止しました。ENA NIC は4つの combined queue に設定し、IRQ をコア0〜3へ固定しました。この処理がないと、カーネルがサーバーやクライアントのスレッドと同じコアへ割り込みを振るため、実行ごとに結果が変動します。この速度で測定するなら、先に IRQ を固定しておくと後で助かります。
# Run on both machines. ens50 is the ENA interface name on these instances.
sudo systemctl stop irqbalance
sudo ethtool -L ens50 combined 4
i=0
for irq in $(grep ens50 /proc/interrupts | awk '{print $1}' | tr -d ':'); do
  echo $((i%4)) | sudo tee /proc/irq/$irq/smp_affinity_list > /dev/null
  i=$((i+1))
done
クライアント。 cachecannon 上の valkey-lab を使い、コア4〜19に固定した16ワーカースレッド、32接続、パイプライン深度1で実行しました。読み書きは別々に測定しました。読み取りではキー空間を事前に埋め、ヒット率100%で実行します。各短時間測定は5秒のウォームアップ後の15秒間で、16バイトのキー500個を使いました。
AWS は単一 TCP フローを約9.5 Gbpsに制限するため、32接続を維持しました。iperf3 では9.53 Gbpsを確認しました。200 Gbps NIC を使い切るには、複数フローに負荷を分散する必要があります。
各測定につき1回実行し、-s で値のサイズを変えました。
# GET pass: prefill the 500-key keyspace, then measure at a 100% hit rate.
valkey-lab -h <server> -c 32 -P 1 -t 16 --cpu-list 4-19 \
  -n 500 -r 100:0 --prefill --warmup 5s -d 15s \
  -s <value_bytes> --key-size 16

# SET pass.
valkey-lab -h <server> -c 32 -P 1 -t 16 --cpu-list 4-19 \
  -n 500 -r 0:100 --warmup 5s -d 15s \
  -s <value_bytes> --key-size 16
結果の範囲。 単一ノード、TLS なし、永続化なし、32本の閉ループ接続、パイプライン深度1、ヒット率100%のテストです。表の大半はウォームアップ後の15秒間1回の測定です。結果はこの環境とワークロードを示します。より広い本番環境について主張するには、繰り返しの測定と追加構成が必要です。
個々の変更ではなく、リリース全体を測定しています。本記事で挙げたプルリクエストは、有力な説明として扱い、因果関係の証明とはしていません。
Valkey の運用者にとっての意味
この単一ノード・TLS なしのテストでは、Valkey 9.x は8.xに対して64 MBの読み取り帯域幅を約6倍にし、p99 を1秒弱から約230 msへ減らします。以前の混合ワークロードのテストでも、大きな読み取りが来た際、小さなリクエストへのレイテンシの悪影響が大幅に減りました。
実務上の結論は「Valkey は常に速い」というものより限定的です。このワークロードでは Valkey 8.1は基本的に横ばいで、9.0が大きな GET の経路を変え、9.1がこの環境の大きな SET を改善します。大きな値が重要なら、小さなオブジェクトのベンチマークや本結果から推測せず、自分のサイズ分布、同時実行数、TLS、永続化の設定で9.xを検証してください。
Valkey は性能、メモリ効率、大規模環境の可用性を継続して改善しています。各版には、実際のユーザーが本番で直面する問題に基づく改善が加わります。収益のために機能を出し惜しみする動機がなく、誰もが継続的な改善を追求する活気あるコミュニティこそ、Valkey の特別な点です。努力は足し算、継続は掛け算です。
メガバイト級のオブジェクトを回線速度で提供することに、最近多くの時間を使っています。大きなオブジェクトに取り組んでいる方は、ぜひ話しましょう。Valkey Slack でお待ちしています。