Valkey で実現する推論向けの高速な共有コンテキストメモリ
Momento は Valkey 向けの Large Object モジュールを発表しました。ゼロコピー RDMA と階層化された NVMe ストレージにより、vLLM と SGLang が LMCache 経由で利用できる高速な共有 KV キャッシュを実現します。
 Daniela Miao
 Tony Valderrama
現在の AI 推論基盤には、メモリの課題があります。 GPU クラスターがフル稼働しているとき、各ワーカーは新しい入力を処理し続け、出力トークンのデコードに使う生のテンソルであるアテンション状態を生成します。出力が完了すると、次のリクエストを処理するために、そのデータは破棄されます。
多くのワークロードでは、会話のターンごとに履歴を積み重ねるため、長いテキストのうち同じ部分が推論に繰り返し渡されます。アテンション状態が失われると、ワーカーは同じ入力から同じ状態を再計算するために、高価な GPU の計算資源を消費します。一方で、ワーカーが生成するデータは膨大で、ローカルの DRAM と NVMe だけではすべてを保持できません。
vLLM や SGLang などの推論エンジンは、アテンションブロックをそのまま再利用できることに着目し、このデータを永続的な共有ストレージへ移し始めています。この新しい AI インフラの構成要素が、コンテキストメモリです。
Valkey は、無償で利用できるオープンソースのキャッシュとして最も広く導入されており、効率的で低レイテンシなシステムを構築するエンジニアにとって身近な選択肢です。今回、Momento と AWS は Valkey の Large Object モジュールを共同開発しました。RDMA によるネットワーク転送や NVMe ストレージの階層化により、使い慣れた Valkey を高性能なコンテキストメモリ基盤として活用できます。
コンテキストメモリのストレージ階層
GPU から離れたストレージほど、容量あたりのコストが下がり、より多くのデータを保持できますが、アクセス速度は低下します。NVIDIA Dynamo、vLLM、LMCache、SGLang の HiCache などの主要な推論フレームワークでは、コンテキストメモリのストレージを主に次の 4 階層に分けています。
- G1. GPU の HBM — 使用中のアテンション状態
- G2. ローカル DRAM — 使用中のアテンション状態の一時格納とバッファリング
- G3. ローカル SSD — 短い間隔で再利用されるホットな状態
- G4. 共有ストレージ — 多数のワーカーがアクセスする共有状態
G4 には一般に、S3 Express One Zone、WEKA、MinIO などの高速なオブジェクトストレージを使います。近年では、ピアツーピア共有(Mooncake)やネットワーク接続型 NVMe(NVIDIA BlueField)などの構成が登場し、G3 と G4 の境界は曖昧になっています。
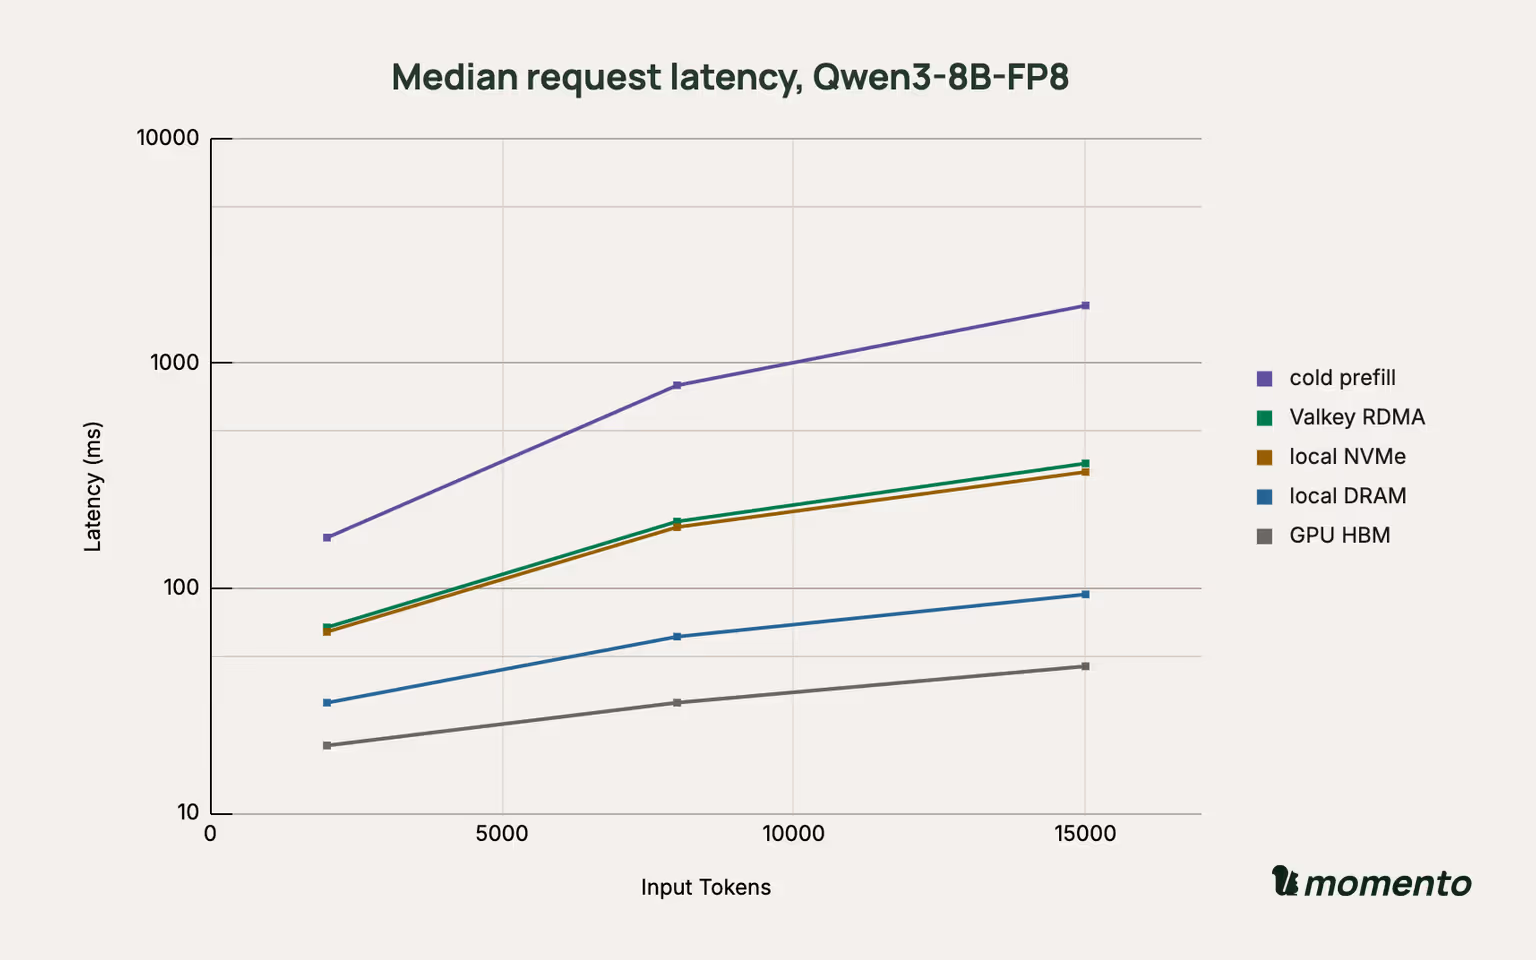
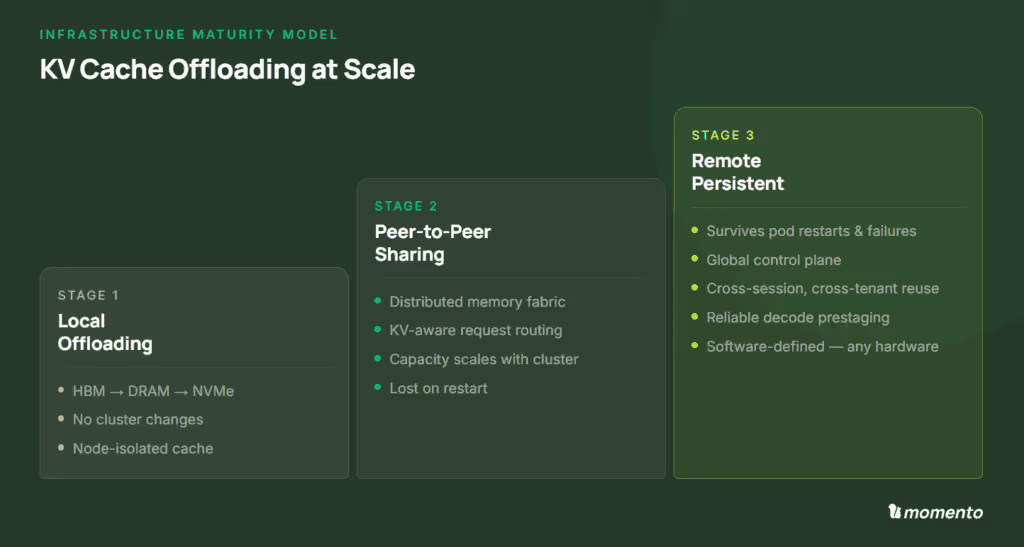
Valkey は G3 と G4 の間に位置し、DRAM と NVMe からなる大容量で永続的な共有ストレージに、きわめて低いレイテンシでアクセスできます。私たちの予備検証では、リモートの Valkey 階層はワーカー間のピアツーピア転送と同等の速さで、ワーカーのローカル NVMe キャッシュよりわずか 5% 遅いだけでした。
永続的なコンテキストメモリの運用
ローカルキャッシュ、ピアツーピア転送、Valkey の性能は近いものの、コンテキストメモリを保持できる期間は異なります。ローカルキャッシュのアテンションブロックは個々のノードに、ピアツーピア転送では単一のクラスターに依存します。リモートストレージなら、個々の推論ワーカーやクラスターの稼働期間を超えて、コンテキストメモリを保持できます。
ストレージとコンピュートの分離は、推論基盤を信頼性の高いクラウドネイティブな構成に進化させる自然な流れです。リソースを独立した層に分けることで、信頼性が向上し、容量も管理しやすくなります。プラットフォームチームは、ワークロードの変動に応じて各コンポーネントを個別にスケールできます。GPU クラスターを別のモデルや構成に動的に切り替えても、データの消失やコールドスタートを避けられます。
使い慣れた製品を再利用することも、運用効率の向上につながります。Valkey と Redis は世界で最も広く利用されているキャッシュ技術です。分散 KV キャッシュに採用すれば、実績のある高性能なツールをそのまま活用できます。
大規模な推論には、まだ解明されていない難しい課題が数多くあります。共有コンテキストメモリは、使い慣れた技術で運用できます。
コンテキストメモリ再利用の経済性
リモートストレージの利点は、運用のしやすさだけではありません。アテンション状態の各ブロックには、すでに GPU の計算コストがかかっています。そのコストを再利用によって回収できるのは、一致するリクエストが届いた時点で、そのブロックがまだ利用できる場合です。数秒後のツール呼び出し、1 時間後に再開するエージェント、数日後に使われる共通のシステムプロンプトなど、再利用のタイミングはさまざまです。
ブロックの保持には、時間あたりわずかなコストがかかります。ストレージが安価なほど、累積の保管コストが GPU での再計算コストを上回るまで、ブロックを長く保持できます。数分から数時間で再利用するなら DRAM、数日なら NVMe、それ以上ならオブジェクトストレージが費用に見合います。キャッシュを共有すれば、ブロックが再利用されてコストを回収できる機会も増えます。
モデルが進化するにつれ、保持するメリットはさらに大きくなります。コンテキストが長くなるほど、プリフィルの計算コストは増えます。一方で、モデルアーキテクチャにはアテンション状態を圧縮する新しい手法が取り入れられています。保存される 1 バイトあたりの計算量が増えるため、より長く保持する価値が生まれます。
このメリットを大規模な環境で得るには、数 MB のブロックを高速に転送し、低コストなストレージ階層に配置できるデータストアが必要です。
コンテキストメモリに向けた Valkey の進化
推論基盤を運用するお客様は、共通の課題を抱えていました。数 MB に及ぶアテンションブロックは、DRAM に保持するとコストが高く、ネットワーク越しにコピーするにも時間がかかります。私たちが Large Object モジュールを開発したのは、この課題を解決するためです。Valkey には、お客様が求める速度と運用のしやすさがすでに備わっていました。そこで AWS とともに、低コストの階層型ストレージと GPU を搭載する推論ワーカーのホストメモリへの直接転送経路を追加することにしました。
Valkey は Linux Foundation の運営のもと、活発なコントリビューターコミュニティに支えられ、大規模環境での効率と性能を重視しています。Valkey の Large Object モジュールには、高速な共有コンテキストメモリに適した機能がいくつも加わりました。
このモジュールは、数 MB のアテンションブロックを DRAM と NVMe にまたがって保管し、ストレージコストを大幅に削減します。私たちは、サーバーと推論ワーカーのホストメモリの間でブロックを高速に転送できるゼロコピー RDMA 経路を追加しました。また、LMCache との連携機能を提供し、vLLM や SGLang から Valkey を簡単に利用できるようにしました。
これらの機能を組み合わせることで、より多くのコンテキストを長く、低コストで保持でき、既存の GPU をさらに有効活用できます。まずは Large Object モジュールをお試しください。お使いの環境に Valkey を導入する場合は、Momento Valkey Operator を使った構成について Momento にご相談ください。フルマネージドサービスをご希望の場合は、Momento Cache をご利用いただけます。