同時実行数の崖を生むのはメモリの限界
KV キャッシュが満杯になるまで p50 は正常に見えます。その後 p99 は一段階で15倍に跳ね上がっても、平均値のダッシュボードは異常を示しません。崖の正体はメモリです。
 Khawaja Shams
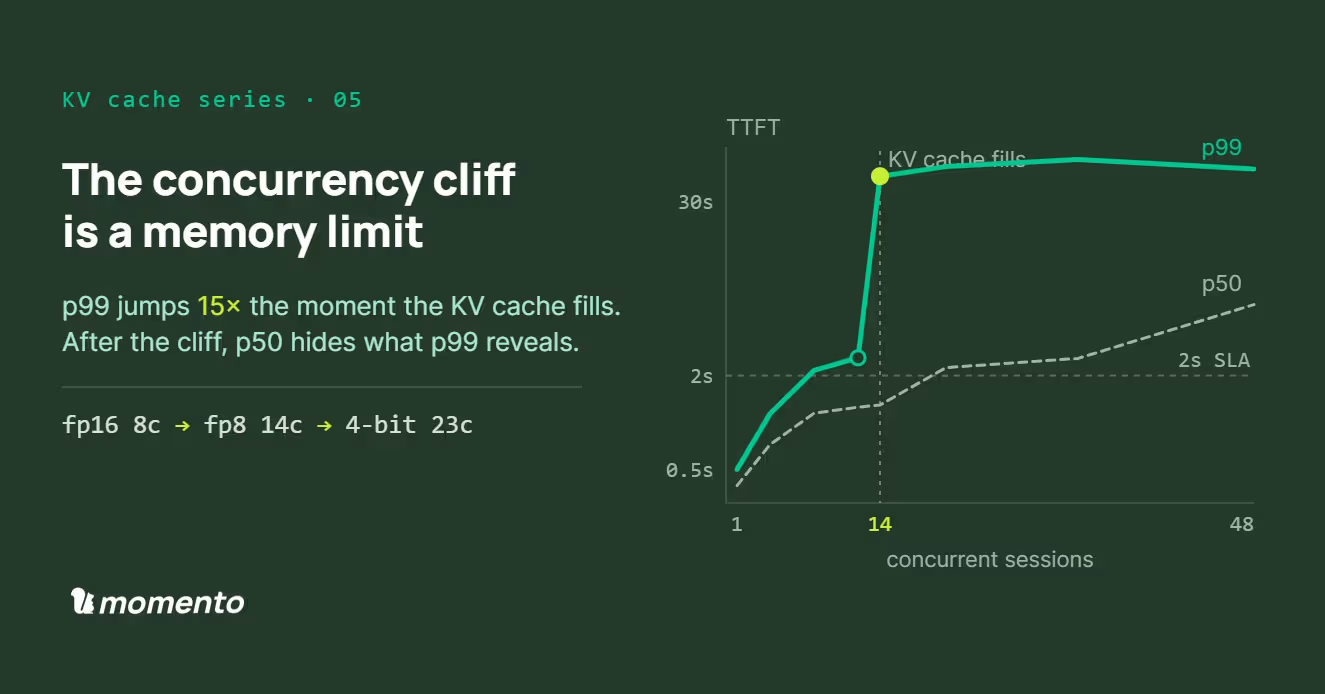
推論サーバーの同時利用者を増やすと、通常レイテンシは少しずつ上がります。しかし KV キャッシュを使うサービングはそうではありません。横ばいを保った後、崖を落ちるように急激に悪化します。
1台の L4 上で Qwen3-4B のコーディングエージェントを動かすと、12の同時セッションでは p99 を2.6秒未満に保てます。2セッション増やすだけで p99 は39秒となり、一段階で15倍に増えます。この崖は、KV キャッシュが満杯になる瞬間です。
汎用ハードウェア上のコーディングエージェント
構成は NVIDIA L4 GPU(VRAM 24 GB)を1基搭載した EC2 g6.4xlarge 1台です。vLLM 0.20.2 上で FP8 重みの Qwen3-4B を実行し、自動プレフィックスキャッシュ(APC)を有効にしました。
ワークロードは、作業中の軽量コーディングエージェントを模しています。各セッションは共通の10,000トークンのシステムプロンプト(リポジトリのコンテキストとエージェントへの指示)で始まり、12ターンの会話が続きます。各ターンでは、ツール呼び出しの入力、コード片、応答など、固有のコンテキストを約1,000トークン追加します。12ターン目にはセッションあたり約22,800トークンになります。出力は1ターン75トークンに制限します。エージェント型ワークロードでよく見られるように、入力が大きな割合を占めます。
System prompt:          10,000 tokens  (shared across sessions → APC cached)
Per-session turns:      ~12,800 tokens across 12 turns  (unique per session)
Output per turn:        75 tokens
—————————————————
Total at turn 12:       ~22,800 tokens
APC はシステムプロンプトを1度だけキャッシュし、すべてのセッションで KV のコストを分担します。ブロックは GPU メモリを使いますが、コピーは1つだけです。セッション内でも、増加するターン履歴をキャッシュします。ターン n+1 はターン n の正確なプレフィックスを延長するため、前のターンの KV ブロックが残っていれば、新しい約1,000トークンだけをプリフィルすれば済みます。ただし各セッションの履歴は、コードやツール出力が異なるため、セッション間では共有できません。同時実行の圧力でセッションのブロックが追い出されると、次のリクエストは蓄積した履歴全体(12ターン目では最大約12,800トークン)を再プリフィルする必要があります。そのコストが TTFT の急激な悪化を引き起こします。
同時実行数を1〜48セッションに変え、KV キャッシュの精度を fp16、fp8、TurboQuant 4-bit の3種類で測定しました。また、最良条件(すべてのコンテキストがキャッシュ済み)と最悪条件(すべて再プリフィル)の両端も測り、現実的な性能が入る範囲を確認しました。
同時実行数の崖
次のグラフは、fp8 KV キャッシュで同時実行数を変えたときの TTFT のパーセンタイル(p50、p95、p99)とスループットです。縦軸は対数ですが、それでも崖がはっきり見えます。
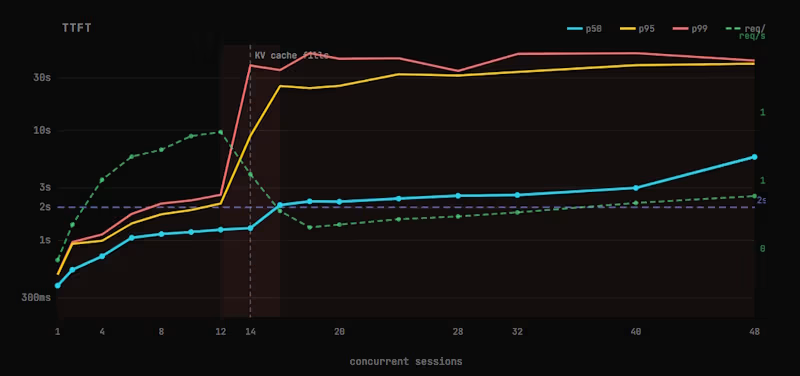 同時セッション数に対する TTFT p50、p95、p99 と、右軸のスループット。g6.4xlarge(L4)上の Qwen3-4B FP8 と fp8 KV キャッシュを使用。網掛けは12〜16セッションでの性能低下、破線は14cで KV キャッシュが満杯になる地点を示します。
同時12セッション以下では p99 TTFT は2.6秒未満に収まり、スループットはピークの1.36 req/sまで上がります。14セッションでは p99 が一気に38.9秒へ、15倍に増え、同時にスループットも23%低下します。
12セッションなら、すべて KV キャッシュに収まります。14では満杯になり、別セッションのブロックを追い出します。追い出されたセッションは、次のターンで固有コンテキスト12,800トークン全体を再プリフィルしなければならず、連鎖的にレイテンシが悪化します。
崖は12〜14セッションの間にあり、その後のスループットは12cでのピークを回復しません。p99 を2秒以内に収める SLA では、安全な運用点は同時6セッションです。
崖を越えると、p50 は実態を隠す
崖を越えると、p50 と p99 は異なる状態を示します。20cでは p50 が2.2秒で許容できそうに見えますが、p99 は44.8秒で、そうはいきません。APC が2つのリクエスト群を作るため、分布は二峰性になります。運のよいリクエストはセッションのウォームなキャッシュにヒットし、最新ターンだけをプリフィルしてすぐ終わります。運の悪いものはブロックが追い出された後に到着し、12,800トークン全体を再プリフィルして、高負荷時には30〜50秒かかります。
p50 は運のよい群を、p99 は運の悪い群を反映します。崖を越えた後、TTFT の平均値1つに意味はありません。障害を見るにはテールを見る必要があります。
測定点をいくつか並べると、12セッションまでの横ばい、14での崖、その後に広がる p50/p99 の差という全体像がわかります。
| セッション数 | TTFT p50 | TTFT p95 | TTFT p99 | req/s |
|---|---|---|---|---|
| 1 | 388 | 487 | 493 | 0.42 |
| 6 | 1.06s | 1.43s | 1.75s | 1.18 |
| 10 | 1.19s | 1.89s | 2.31s | 1.33 |
| 12 | 1.25s | 2.16s | 2.60s | 1.36 |
| 14 | 1.29s | 8.93s | 38.9s | 1.05 |
| 20 | 2.25s | 25.5s | 44.8s | 0.68 |
| 48 | 5.74s | 40.5s | 43.2s | 0.89 |
KV キャッシュの精度が急変点を動かす
同じワークロードを16ビットの KV キャッシュで動かすと、トークン容量は半分になり、急変点も比例して左へ移ります。vLLM は --kv-cache-dtype が未設定の場合、モデルの dtype を使い、Qwen3 では bf16 が初期値です。
| KV dtype | ビット/要素 | トークン容量 | 急変点(セッション数) | p99 2秒以内の上限 |
|---|---|---|---|---|
| bf16/fp16 | 16 | ~89K | ~8 | ~4 |
| fp8 | 8 | ~178K | ~14 | ~6 |
| TurboQuant 4-bit | ~4.2 | ~275K | ~23(推定) | 未確認 |
fp16 から fp8 への変化は確認済みです。急変点は約8から約14へ移り、容量が2倍になると1.75倍になりました。2倍を少し下回るのは想定内です。KV 管理のオーバーヘッドとブロックテーブルの断片化は、精度にかかわらず容量の一部を消費するためです。
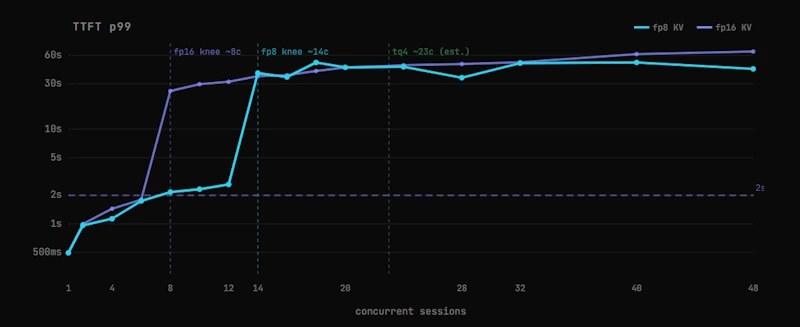 同じワークロードと GPU での fp8 KV と fp16 KV の TTFT p99。マーカーは観測した急変点で、fp16 は8セッション、fp8 は14です。tq4 の約23という地点は容量に基づく推定で、実験による確認待ちです。
量子化は、同時実行の余裕を直接増やします。fp16 から fp8 へ精度を半分にすると、崖に達するまでに収まる同時セッション数はほぼ倍になります。TurboQuant 4-bit は要素あたりのバイト数が fp16 の約3.8分の1ですが、自動調整用の作業領域のため gpu_memory_utilization を下げる必要があり、一部相殺されます。それでも急変点は約23c、fp16 の約3倍と予測されます。
精度のトレードオフは小さい可能性があります。4ビットの KV キャッシュ量子化では、一般にパープレキシティへの影響は1桁台の低い値と報告されますが、正確な影響はモデルとタスク次第です。同じ GPU で、追い出しが始まる点は約8(fp16)から約14(fp8)、推定23(tq4)へ移り、約3倍のセッションを扱えるようになります。
最良条件、最悪条件、現実的な条件
本質的に必要なレイテンシ(プリフィル計算)と、回避可能な部分(キャッシュミス)を分けるため、現実的なワークロードに加えて、制御した2つの境界条件を測定しました。
最良条件(miss_rate=0.0)では、すべてのリクエストが同じキャッシュ済み内容にヒットします。APC がセッションコンテキスト12,800トークン全体を保持し、固有の約200トークンだけをプリフィルします。KV を完全に活用する条件です。
最悪条件(miss_rate=1.0)では、各リクエストに固有のプレフィックスを与え、ユーザーコンテキストの APC を無効にします。10Kのシステムプロンプトにはヒットしますが、セッション履歴の約12,800トークンは毎回すべて再プリフィルします。どのミスも最も深い12ターン目で起きるため、毎回最大の再プリフィルコストがかかります。
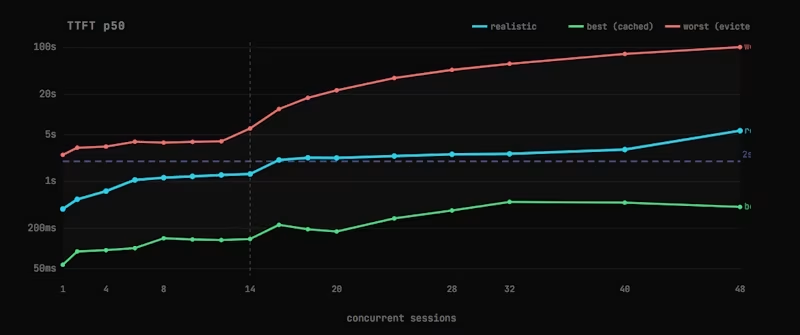 最良(完全にキャッシュ)、現実的(自然な APC)、最悪(常に再プリフィル)の TTFT p50。対数スケールで表示。最良と最悪の間が、現実のワークロードが収まる範囲です。
境界条件からわかること
競合のない同時1セッションでは、3つの条件が明確に分かれます。
| ワークロード | TTFT p50 | 動作 |
|---|---|---|
| 最良(キャッシュ済み) | 57 ms | 固有の約200トークンだけをプリフィルし、残りはキャッシュから取得 |
| 現実的(APC) | 388 ms | システムプロンプトはキャッシュ済み、固有の12,800トークンをプリフィル |
| 最悪(追い出し済み) | 2,500 ms | システムプロンプトはキャッシュ済み、最大深度のユーザートークン約12,800個を毎回再プリフィル |
絶対値で見ると、現実的条件の388 msは、最悪の2,500 msより最良の57 msにずっと近い値です。それでも最良の7倍かかります。この差は、リクエストごとにセッション固有の約12,800トークンをプリフィルするコストです。APC はシステムプロンプトのコストを取り除きますが、各セッションのターン履歴は計算する必要があります。
現実的条件と最悪条件の差は、ミスが起きる深度です。現実的なワークロードでは、どのターンでもミスが起きます。3ターン目で追い出されれば約3,000トークンを再プリフィルしますが、12ターン目なら約12,800トークンです。最悪条件では、すべてのミスを最大深度に固定し、毎回最大コストを払います。実際のトラフィックにはミス深度の分布があるため、現実的なレイテンシは最良条件に近くなります。
驚くべきなのは最良条件です。セッションコンテキストを完全にキャッシュできれば、L4 は p99 2秒の SLA 内で48を超える同時セッションを処理できます。現実的条件での6セッションという上限は、共有できないターン履歴、つまりセッション固有のコンテキストのコストです。GPU の計算能力の限界ではありません。
最悪条件では、同時セッションが1つ増えるごとに約2.1秒ずつ線形に伸び、48cでは102秒になります。スループットは6セッション以降、0.32 req/sで飽和します。GPU は各リクエストの12,800トークンの再プリフィルに使い切られ、同時実行数を増やしてもキューが長くなるだけです。
急変点が決まる理由
L4 には24 GBの VRAM がありますが、KV キャッシュに使える量はずっと少なく、実際には総 VRAM の約半分です。
メモリの使い道
fp8 と fp16 の実験では、vLLM の gpu_memory_utilization を0.9にして、約21.6 GBを確保しました。モデルの重み、CUDA グラフのキャプチャー、活性化テンソル、ブロックテーブルの負担を引くと、KV キャッシュには約13 GBが残ります。TurboQuant の実験は0.8でした。起動時の torch.inductor の自動調整に追加の作業領域約2 GBが必要なためで、残るのは約10.6 GBです。
トークンあたりの KV キャッシュ
Qwen3-4B は36層、8 KV ヘッド、head_dim 128の GQA を使います。トークンあたりの KV キャッシュサイズは精度で変わります。
2 (K+V) × 36 layers × 8 KV heads × 128 head_dim × bytes_per_element

FP16/BF16: ... × 2 bytes = 147,456 bytes/token  → ~89K tokens in ~13 GB
FP8:       ... × 1 byte  =  73,728 bytes/token  → ~178K tokens in ~13 GB
TQ4:       ~0.53 B effective (4-bit + quantization metadata)
           =  ~38,700 bytes/token  → ~275K tokens in ~10.6 GB
APC を使った容量計算
APC では、10,000トークンのシステムプロンプトを1度だけ保存して共有します。独自のブロックが必要なのは、セッション固有のコンテキスト(最大深度で約12,800トークン)だけです。
FP8 KV
Token budget:     ~178K
Shared prefix:     10K (1×)
Available:        ~168K
Per-session:      ~12.8K
Max sessions:   168K / 12.8K ≈ 13      Observed knee: ~14c

FP16 KV
Token budget:      ~89K
Shared prefix:     10K (1×)
Available:         ~79K
Per-session:      ~12.8K
Max sessions:    79K / 12.8K ≈ 6       Observed knee: ~8c

TQ4 KV (estimated)
Token budget:     ~275K (0.8 util)
Shared prefix:     10K (1×)
Available:        ~265K
Per-session:      ~12.8K
Max sessions:   265K / 12.8K ≈ 21      Predicted knee: ~23c
計算は、観測値から1〜2セッションの差で急変点を予測します。観測14セッションに対し予測13という小さな上振れは、すべてのセッションが同時に最大深度にならないためです。早いターンではコンテキストが小さいので、容量が尽きるまでに数セッション分の余裕が生まれます。
この構成では、同時実行数の崖はメモリの限界です。制約を決めるのは、何セッション分の KV キャッシュを同時に VRAM に収められるかです。最良条件もそれを裏付けます。完全にキャッシュできれば、同じ GPU が p99 2秒以内で48を超えるセッションを処理できます。計算、スケジューリング、連続バッチ処理も影響しますが、上限を決めるのはメモリ容量です。
自分のワークロードの急変点を求める
急変点は3つの変数で決まります。利用可能な KV キャッシュメモリは、総 VRAM から重み、CUDA グラフ、活性化、断片化を引いた量で、通常は総量の約半分です。正確な量は vLLM が起動時に報告します。セッション固有のコンテキストは、最大深度の総トークン数から APC で共有するプレフィックスを引いたものです。KV 精度は要素あたりのバイト数で、fp16 から fp8、4ビットへと半分にするたびに、トークン容量がおよそ倍になり、急変点が右へ移ります。
推定式は、最大同時セッション数 ≈(トークン容量 − 共通プレフィックス)/ セッション固有のコンテキストです。
今回の構成(Qwen3-4B、L4、共通プレフィックス10Kを含む22.8Kトークンのエージェントセッション)では、計算上は fp8 で約13、fp16 で約6セッションです。観測した急変点は約14と8でした。計算で大まかに見積もり、同時実行数を変える試験で正確な値を求めます。差が出るのは、セッション深度のばらつき、ブロックの断片化、APC の再利用パターンによるものです。
ワークロードが変われば各変数も変わります。セッションあたり2Kトークンの単一ターン QA なら、急変点はずっと高くなります。50Kトークン入力のコードレビューエージェントでは低くなります。VRAM の多い GPU(A100、H100)なら予算が増えます。方法は共通です。予算を見積もり、セッションあたりのコストで割り、試験で確認します。
デプロイにおける意味
同時実行数の制限を決める前に、KV の容量を把握してください。急変点より下なら、安定したレイテンシと有効なキャッシュで最良のスループットを得られます。上ではスループットもレイテンシも悪化し、APC への投資が無駄になります。
KV 量子化は、同時実行数を直接増やします。この L4 では fp16 から fp8 に変えると、p99 2秒の SLA 上限は約4から6へ(50%増)、追い出しの急変点は約8から14へ(75%増)移ります。要素あたりのバイト数を半分にした直接の結果です。量子化はメモリを生み、メモリは同時実行数を生みます。
平均ではなく、テールレイテンシを監視してください。崖を越えると p50 は管理可能に見えても、p99 は壊滅的です。二峰性の分布では、1秒未満で応答を受ける人がいる一方、40秒以上待つ人もいます。平均ベースのダッシュボードは、苦情が出るまでそれを隠します。
レイテンシに余裕のあるバックグラウンド処理のセッションは、対話型の処理経路から分けて実行してください。キャッシュメモリを競合させる必要はなく、分けることで低い TTFT が必要なセッションに KV 容量を回せます。
数値にはいくつかの留意点があります。実験では実際のコードではなく合成トークンを使っています。構造は12ターン固定ですが、実際のエージェントの深度は大きく変わります。ポアソン到着では、即座に次のリクエストを送るエージェントの突発的トラフィックを再現できません。高い同時実行数での p99 は不安定です。1回約200リクエストなら、遅い方から2番目にすぎないためです。今回は無効のチャンク化プリフィルを使えば、急変点の変化を滑らかにできるかもしれません。数値は1台の L4 と Qwen3-4B に固有です。大型モデル、複数 GPU、異なるコンテキスト長では絶対値が変わりますが、傾向は同じです。
KV キャッシュはシステムの問題として振る舞います。同時実行数の急変点は、それが特定の GPU、モデル、ワークロードの形と交わる地点です。計算は簡単です。大切なのは、本番で痛い目に遭う前に計算しておくことです。