vLLM のハッシュチェーン:プレフィックスキャッシュの制約が変わらない理由
自動プレフィックスキャッシュ、ハッシュチェーン、基数木。データ構造が進化しても、再利用は依然として共通プレフィックスに限られます。
 Khawaja Shams
Automatic Prefix Caching(自動プレフィックスキャッシュ)は、通常のプレフィックスキャッシュより大きな問題を解決してくれそうに聞こえます。リクエストをハッシュ化し、キャッシュエントリを自動で見つけ、共通する処理を手動で追跡する必要もありません。再利用できる計算を、どこにあっても発見できる仕組みに見えます。
しかし、再利用の種類は従来と同じです。共通のプレフィックスは再利用できます。共通していてもプレフィックスではない内容は再利用できません。この規則が、現在の推論基盤における再利用の最大の制限です。
最近の KV キャッシュの取り組みの多くは、プレフィックスをより効率よく見つけることに集中しています。ハッシュチェーン、基数木、自動検出は、再利用の仕組みを改善します。しかし、何を再利用できるかは変えません。うまくいくワークロードと限界にぶつかるワークロードを見ると、その理由がわかります。
プレフィックスキャッシュで十分な場合
KV キャッシュの再利用が効果を持つのは、リクエスト間に共通の計算がある場合だけです。したがって問題は、現実のワークロードのどれだけを現在の基盤が再利用できるかです。
多くのエージェント型ワークロードでは、答えは「十分」であることがよくあります。固定されたシステムプロンプト、ツール定義、会話の基本構造が長い共通プレフィックスを作り、推論エンジンはその発見と再利用を得意としています。
一方、多くのワークロードでは、共通するのはプレフィックスだけではありません。RAG パイプラインで、その限界が表れます。システムプロンプトは固定でも、取得する文書はリクエストごとに変わります。同じ5つの文書を異なる順序で含む2つのリクエストがあるかもしれません。意味はほぼ同じでも、トークン列は異なり、キャッシュが照合するのはトークン列です。同じ内容でも位置が違えば、再利用できません。
プレフィックスという制約が残る理由
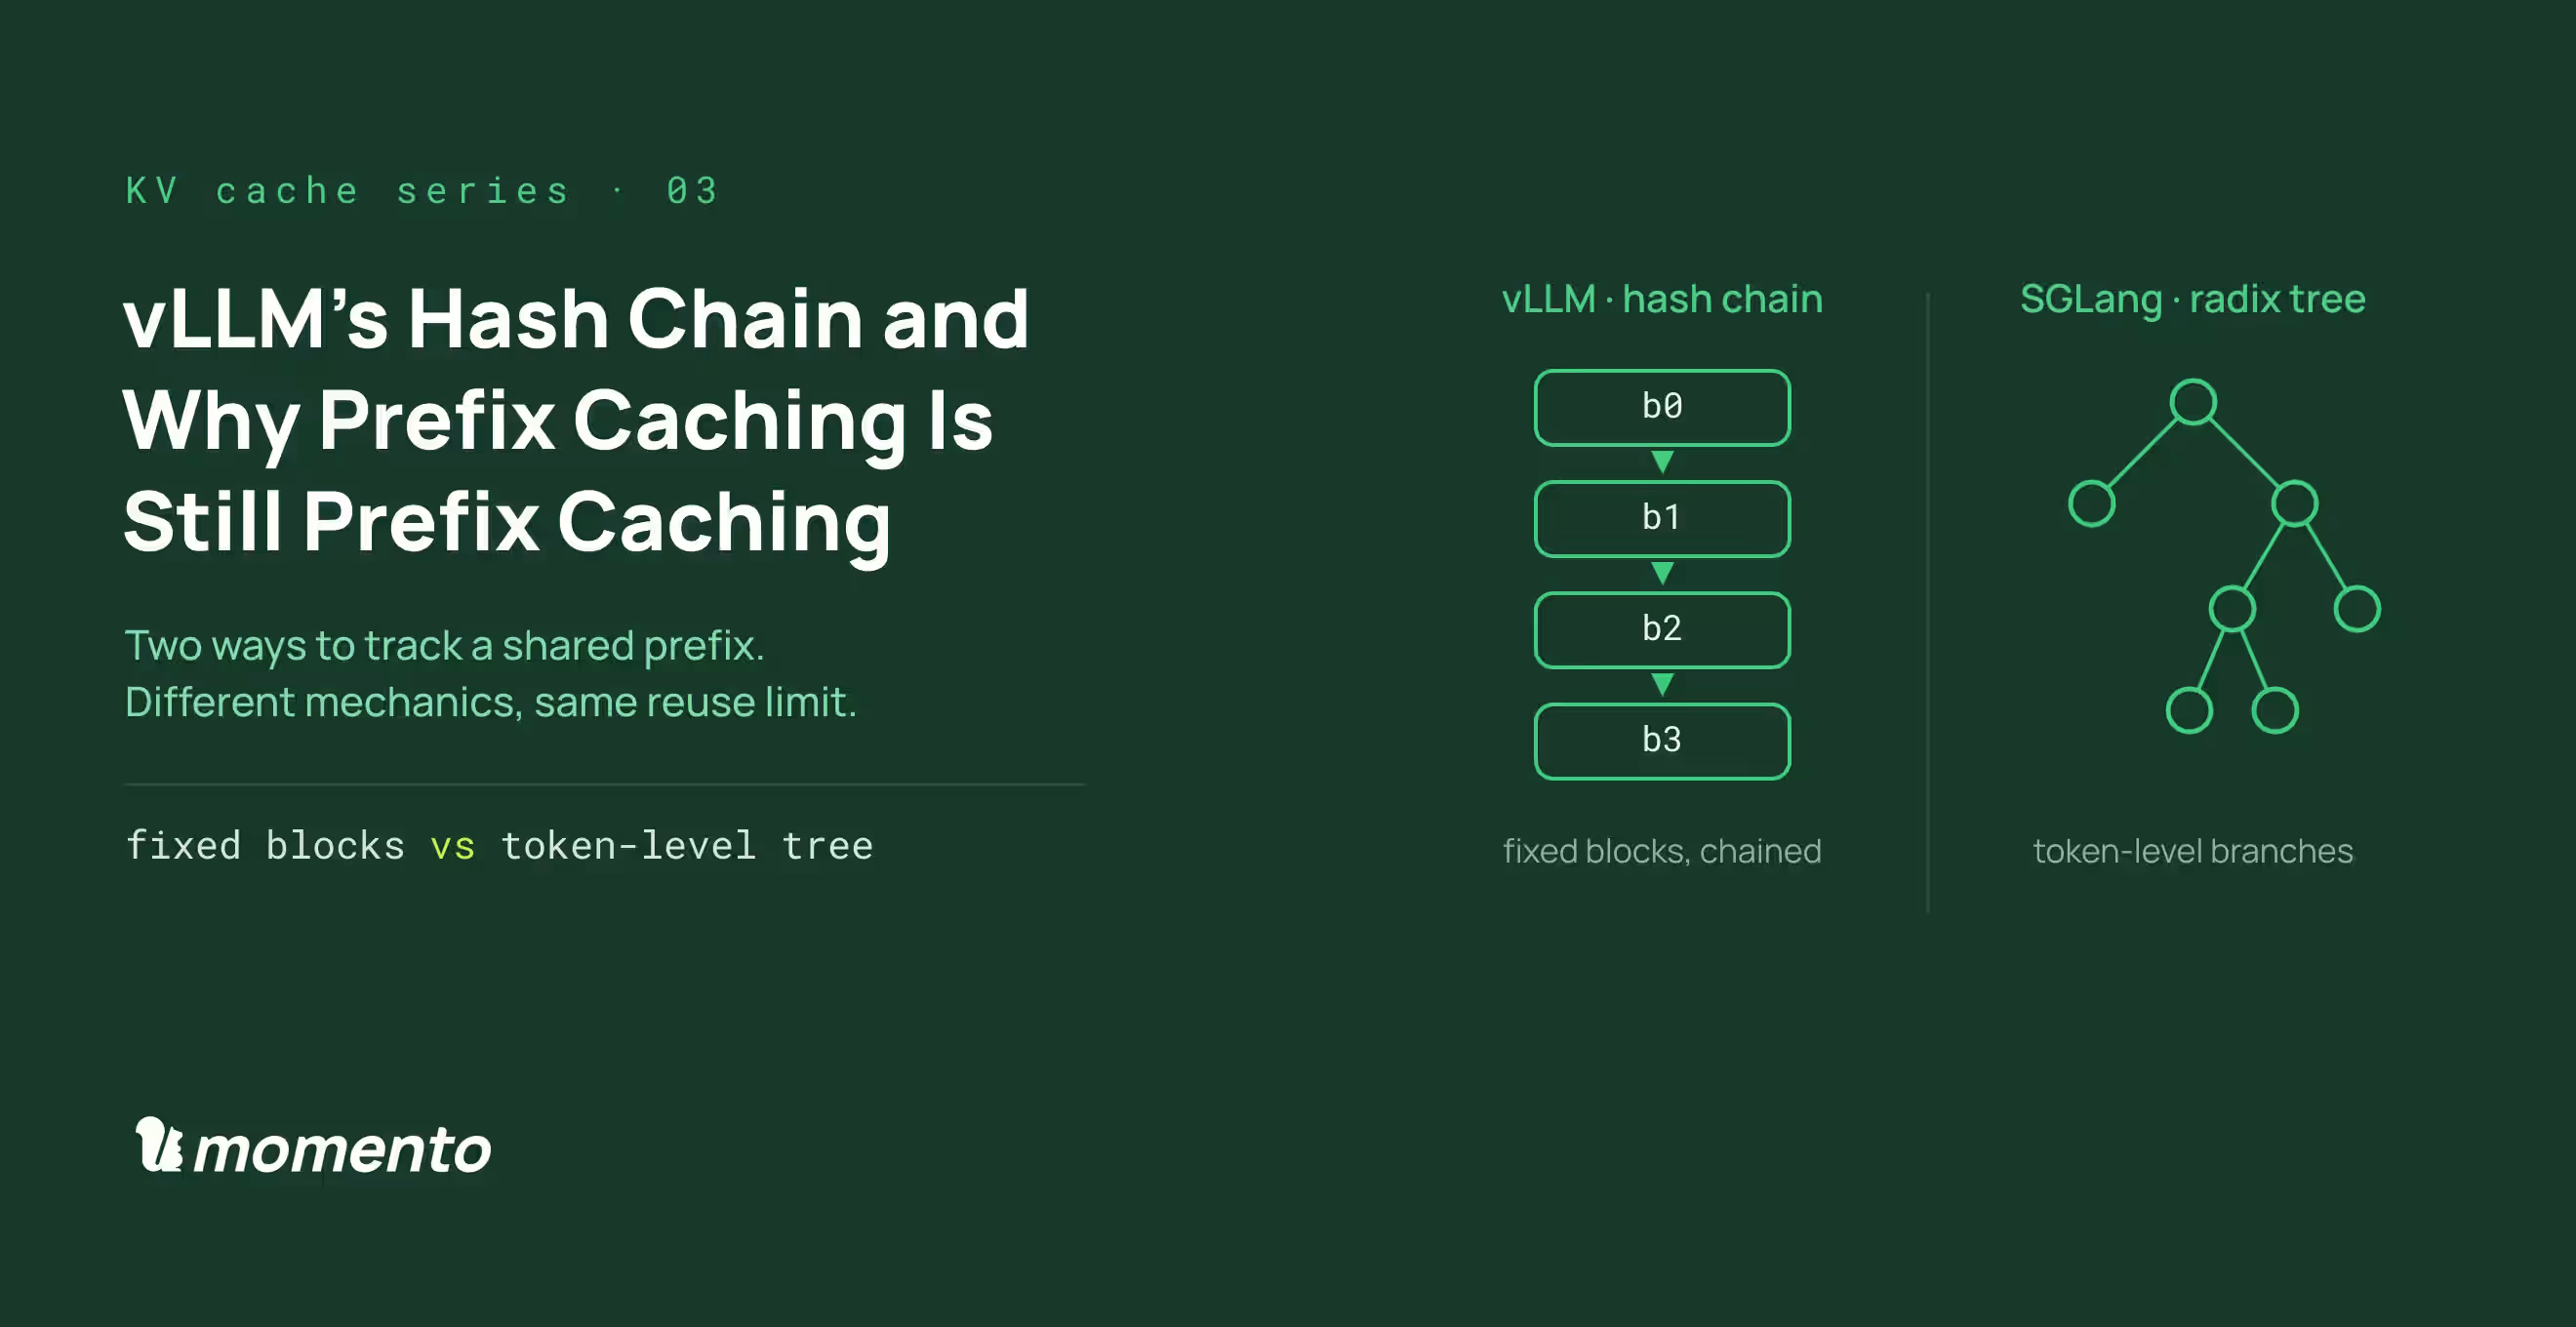
vLLM の Automatic Prefix Caching は、内容のハッシュ化によって明示的なプレフィックス追跡を不要にします。KV キャッシュを固定サイズのブロックに分け、各ブロックに SHA-256 ハッシュを付けます。ブロック N のハッシュには、現在のブロックの内容に加え、それ以前のすべてのブロックのハッシュが組み込まれます。チェーンでつなぐことで、各ブロックは自分の内容だけでなく、それ以前のトークン履歴全体を識別します。
リクエストが届くと、vLLM は入力をブロックサイズごとにハッシュ化し、一致するブロックが存在するか確認します。一致すれば計算済みの KV キャッシュを再利用し、なければ新たに計算します。検索は実質的に定数時間で、追い出しも簡単です。固定サイズのブロックは GPU メモリにもきれいに対応します。
しかし各ブロックのハッシュは、それ以前のすべてのブロックに依存するため、1か所の違いが以降の全ハッシュを変えます。最初の3,000トークンが同じで、3,001番目で分岐する2つのリクエストを考えてください。3,001番目を含むブロックのハッシュが変わり、それ以降もすべて変わります。再利用は分岐点で止まります。共通プレフィックスは自動で見つけられても、分岐した後に現れる共通内容は見つけられません。
再利用はブロック境界でのみ行われます。1,000トークンを共有し、1ブロックが16トークンなら、vLLM は62ブロック、つまり992トークンを再利用し、残りの8トークンを再計算します。長いプレフィックスではこの無駄はわずかですが、短い、または不規則な共通部分では影響が大きくなります。
ブロック内部の照合もありません。16トークン中15トークンが同じでも、ハッシュはまったく異なります。つまりブロック単位で、全部再利用するか、まったく再利用しないかの二択です。実装を簡潔かつ高速に保つ合理的なトレードオフですが、再利用は正確に一致するプレフィックス構造に従う、という制限は変わりません。
異なるキャッシュ構造なら改善できるかもしれません。SGLang はその方法を採ります。固定サイズのブロックをハッシュ化する代わりに、トークン列で索引付けした基数木にキャッシュ状態を保持します。リクエストが届くと木をたどり、一致する最長のキャッシュ済みプレフィックスを見つけます。一致箇所は固定ブロック境界ではなく、任意のトークン境界にできます。これにより、可変長のターン、分岐する会話、不規則なプレフィックス長のワークロードを扱いやすくなります。
それでも基数木が探すのは、最長の共通プレフィックスです。2つのリクエストが分岐すると、その後の列で共有する内容には届きません。SGLang はプレフィックスの見つけ方を改善しますが、再利用をプレフィックスの先まで広げるわけではありません。
プレフィックスの先へ
プレフィックスキャッシュは、KV の再利用が確かに機能することを示しています。次の問いは、分岐した後もどれだけ再利用できるかです。現在のランタイムは共通プレフィックスに最適化されています。次世代が目指すのは、共通セグメント、キャッシュ修復、そしてプレフィックス照合では届かない再利用です。
そのため、現在の研究の多くはキャッシュ修復とセグメント単位の再利用に集中しています。目標は、KV 再利用の価値を証明することから、現在のプレフィックスベースのシステムが取り残している計算を回収することへ移っています。