KV キャッシュの真価は高負荷で現れる
推論の実装の詳細として始まった KV キャッシュは、推論システムの進化に伴い、第一級のシステム要素になりつつあります。
 Khawaja Shams
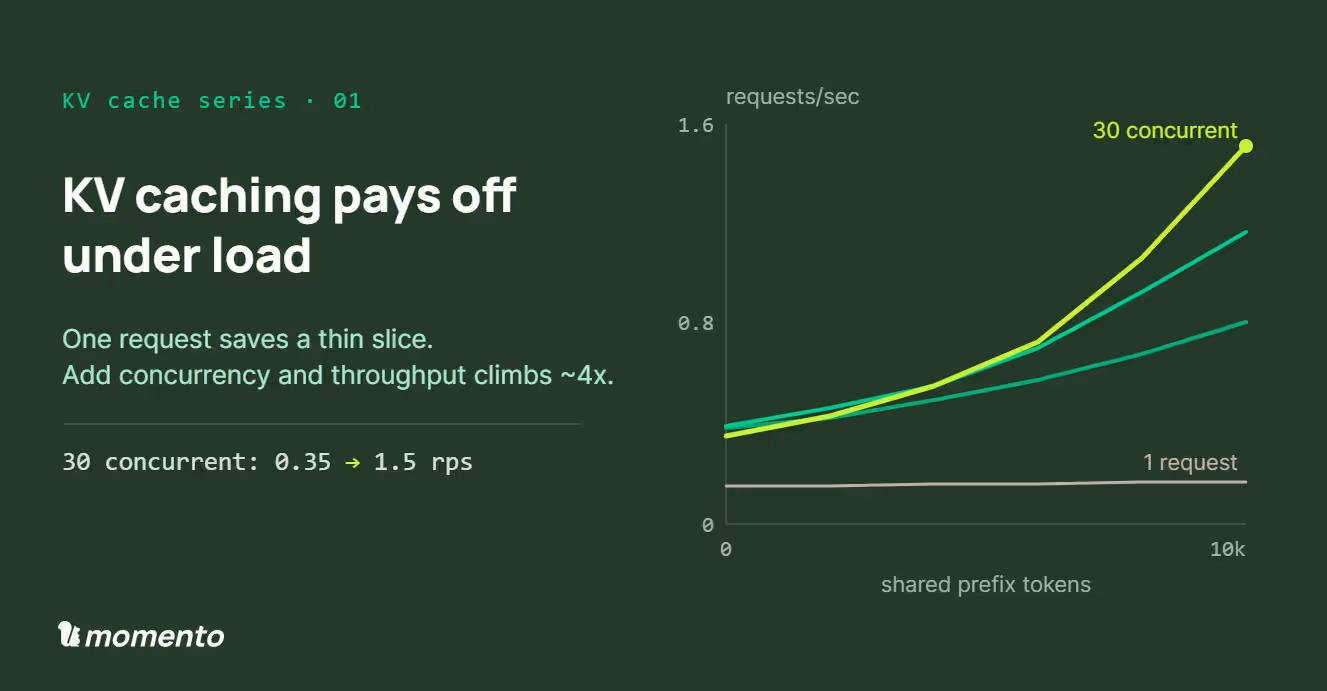
KV キャッシュは、机上では割に合わない選択に見えます。メモリ、複雑さ、運用対象の増加を引き受けて、リクエスト時間を数%短縮するだけです。
ベンチマークも、その印象を覆してくれません。
そこで検討を終えるチームを見てきました。KV キャッシュは1回の順伝播の中では必要なので、リクエストの間だけ保持して終わりにする。それを超えて保持し、リクエスト間で再利用することは、サービング層のぜいたくに感じられます。占有するメモリ、追い出しのロジック、すでに運用が難しい基盤に加わる可動部分を思い浮かべると、数%のレイテンシ削減では見合わないように思えるでしょう。
それも理解できます。単一リクエストで計算すると、長期間保持する KV キャッシュの効果は控えめです。私たちも測定し、最初は魅力に乏しい結果でした。しかし評価単位として単一リクエストは不適切で、本番相当の負荷で測ると経済性が変わります。
単一リクエストでの削減には上限がある
Qwen3-30B-A3B を使った測定の1つでは、入力1K・出力512トークンのリクエストで、TTFT は約135 ms、総レイテンシは約2.5秒でした。TTFT にはプリフィルの計算だけでなく、スケジューリングやキュー待ちの負担も含まれるため、プリフィル部分を約100 msとします。完全なキャッシュヒットによって、それをすべて取り除いても、削減できるのはリクエスト全体の約4%です。これは日常的な効果ではなく、上限と考えてください。
コンテキストが長くなると、総レイテンシに占めるプリフィルの割合も増えます。入力16K・出力512では、総時間3,200 msに対して TTFT は約769 msで、約24%です。1Kの場合から大きく増えています。プリフィルには、コンテキスト長よりも入出力比率の方が強く影響します。入力が大きく出力が小さい場合、コストに占めるプリフィルの割合が大きいため、KV キャッシュは最も効果を発揮します。入力が短く出力が長いと、デコードが支配的になり、キャッシュが役立つ余地はわずかです。
4%や24%だけを見ると、控えめに見えます。しかしレイテンシは目標スループットの下で測るもので、GPU 容量は限られています。スループットが上がると、使用率、キュー待ち、パイプラインの停止によって、プリフィルをやり直すコストが増えます。本番で何千ものリクエストが同じアクセラレーターを奪い合うと、プリフィルは容量とテールレイテンシの問題になります。
したがって、単一リクエストに限れば懐疑的な見方は妥当です。1回のキャッシュヒットが1つのリクエストのレイテンシを大きく減らすかだけを問うなら、答えはしばしば「いいえ」です。入出力比率と、処理のどれほどをプリフィルが占めるかに依存します。このレベルでは、KV キャッシュが必ず得になるわけではありません。
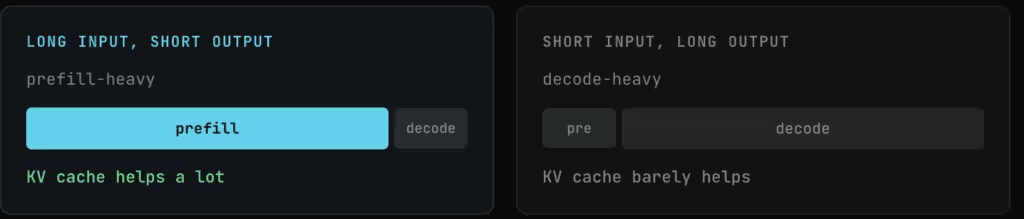
大きな入力と小さな出力を持つワークロードは、減るどころか増えています。エージェント型ワークロードは本質的に複数ターンです。会話履歴、ツール呼び出しの結果、検索したチャンクが積み上がるたびにコンテキストが伸び、各ターンで小さな出力に対して入力が大きくなります。まさにプリフィルが支配的で、キャッシュ再利用の効果が最も大きいワークロードです。
アプリケーションチームにとっては、TTFT の短縮、p95 の改善、リクエスト単価の削減として表れます。GPU を運用するプラットフォームチームには、使用率の向上と、費用あたりの容量増加として表れます。
保持は高価で、再利用も難しい
とはいえ、KV キャッシュの保持は無料ではありません。GPU メモリに置けば、最も希少な領域を実行中の推論と奪い合います。ホストメモリへ移せば安くなりますが、容量は有限で、DRAM の価格動向も不利です。リモートメモリやストレージへ移すと、転送レイテンシ、配置の問題、運用対象の増加を引き受けます。KV キャッシュは賭けです。将来のリクエストが保持中の計算結果を再利用することに、希少なメモリを投じます。
しかし、これは問題の半分にすぎません。メモリ代を払っても、得られる再利用には制約があります。現在、本番で使いやすい選択肢はプレフィックスキャッシュです。後続のリクエストがまったく同じプレフィックスで始まる場合、エンジンは計算済みの KV キャッシュを再利用します。厳密なプレフィックス一致か、再利用なしかという厳しい規則です。現実の多くのワークロードでは、意味が共通していてもプレフィックスは共通しません。検索チャンクの順序変更、異なるツール結果、変化するユーザーコンテキストは、同じ意味内容を異なる位置に持ちます。どれもヒットにならず、ヒット率が下がります。
KV キャッシュには不利な点が多いように見えます。単一ノードでのレイテンシ改善には上限があり、メモリは高価で、再利用モデルは狭い。1ノード上の独立した最適化として評価すれば、複雑さに見合うかが率直な問いです。単独で考えると、見合わないことも多くあります。しかし推論システムは、これらの反論が生まれた当時とは変わっています。どの反論も、プリフィルとデコードを同居させ、大きく高価なキャッシュを保持する単一ノードを前提としていました。その後、2つの変化がありました。1つ目は、プリフィルとデコードをどこで実行するかという構造の変化。2つ目は、キャッシュの保持と移動にかかる費用の変化です。それぞれが、反対理由の別の部分を弱めています。
推論は分散システムの問題になりつつある
プリフィルとデコードは同じ種類の仕事ではありません。プリフィルは計算負荷が高く、デコードはメモリ帯域幅とレイテンシに敏感です。同じアクセラレーターに載せれば、一方を満たすために他方を妥協させます。分ければ、異なる要件を持つ2つのワークロードの間に明確な境界ができます。ただし KV キャッシュは、その境界を越える必要があります。
プリフィルとデコードが異なるハードウェアにあると、KV キャッシュは転送、配置、ライフサイクル管理が必要な、分散システムの第一級の基本要素になります。NVIDIA Dynamo、AWS や Cerebras の分離型基盤は、この分離をインフラ自体へ取り込んでいます。その結果、開発者は KV キャッシュの移動、保存先、保持期間を考えなければならなくなります。
経済性も変わり始めている
2つ目は経済性の変化です。KV キャッシュ自体の保存と移動が、より効率的になっています。最近のモデルの進歩には、実は KV キャッシュの革新が驚くほど多く含まれ、過去18か月の変化は顕著でした。
DeepSeek-V2 と V3 は、Multi-head Latent Attention(MLA)を導入しました。MLA はキャッシュする前に、キーと値を共通の低ランク潜在ベクトルへ圧縮します。V3 では、標準的なマルチヘッドアテンションでトークンあたり約16,384スカラー次元だったキャッシュが、512次元の潜在表現と分離した RoPE 用の64次元、合計576次元になります。MHA 基準では約28分の1です。現在の多くのモデルが使う GQA を基準にすると、グループサイズに応じて約4〜8分の1と控えめになりますが、MLA は GQA が犠牲にする MHA 水準の品質を保ちながら実現します。
Qwen 3.5 は、Gated DeltaNet のハイブリッド構成で別の方法を取ります。アテンション層の75%を Gated DeltaNet の線形アテンションに置き換えます。これらの層はヘッドごとに128×128の固定サイズの状態行列を保持し、トークンごとに段階的に更新します。状態は系列長に比例して増えません。従来の KV キャッシュが必要なのは、残る25%の GQA を使った完全な softmax アテンションだけです。通常 KV キャッシュがメモリを支配する長いコンテキストで、増加の大半をなくせます。効果はコンテキスト長に応じて変わり、256Kトークンでは大きく、1Kでは控えめです。短い場合は固定サイズの状態も小さな KV キャッシュと同程度の容量を使うためです。
Google が ICLR 2026で発表した TurboQuant と PolarQuant は、さらに別の角度から取り組みます。アテンション機構を変えず、KV キャッシュ自体を座標あたり3または4ビットに量子化し、標準ベンチマークで測定可能な精度低下を生じさせません。PolarQuant はランダム直交行列でベクトルを回転し、座標を既知の分布に従わせてから、最適な Lloyd-Max スカラー量子化を適用します。QJL は1ビットの残差補正を追加します。論文では、4ビットで H100 のアテンションが最大8倍高速化し、3ビットでメモリが約6分の1になると報告されています。
正確な数値は基準と設定によりますが、方向は明らかです。MLA はキャッシュを大幅に縮めます。Qwen の Gated DeltaNet のようなハイブリッド構成は、ネットワークの多くの部分でキャッシュの増加を抑えます。TurboQuant などの量子化は、モデル構造を変えずにメモリ要件をさらに減らします。トレードオフは異なっても、対象が小さくなるという流れは共通です。
KV キャッシュへの典型的な反論はメモリコストですが、最近の取り組みはその根拠を大きく弱めます。キャッシュが6分の1から10分の1になれば、経済性は大きく変わります。同じ予算でより多くのエントリが入り、リモートメモリ、SSD、別ノードからの転送も速くなります。キャッシュが無視できるほど小さくなる必要がある、というのは誤解です。本番ワークロードで採算が逆転する程度まで小さくなれば十分です。
ストレージ階層も変化しています。以前は、KV キャッシュは GPU メモリになければ遅すぎて意味がないと考えられていました。今はそう言い切れません。高速インターコネクトとローカル NVMe は改善し続けています。問うべきは、キャッシュの転送や読み込みによって、デコード GPU を繰り返しのプリフィルから解放し、レイテンシに敏感な処理へ集中させられるかです。ストレージ上のキャッシュがプリフィルの負担を減らし、アクセラレーター容量をデコードへ振り向けられるなら、すぐに採算が取れる可能性があります。
成否を最も左右するのはワークロードです。モデルとコンテキスト長が決まったとき、システムはプリフィルの再計算時間と、ネットワーク転送時間、SSD からの読み込み時間、メモリやストレージの確保費用、そもそも再利用される確率を比較します。転送や読み込みが再計算より十分に速く、再利用の可能性も十分高ければ、キャッシュは価値を持ちます。そうでなければ、見返りのないコストです。
負荷が高い状況でのプレフィックスキャッシュ
最近の実験で、この動作を確認しました。L40S 上の Qwen3-1.7B、10Kトークンのプロンプトを使い、複数の同時実行数で共通プレフィックスを0〜10Kトークンに変えました。共通プレフィックスが伸びると、vLLM のプレフィックスキャッシュヒット率は0から1へ上がります。各同時実行数で、スループットとリクエストレイテンシを監視しました。
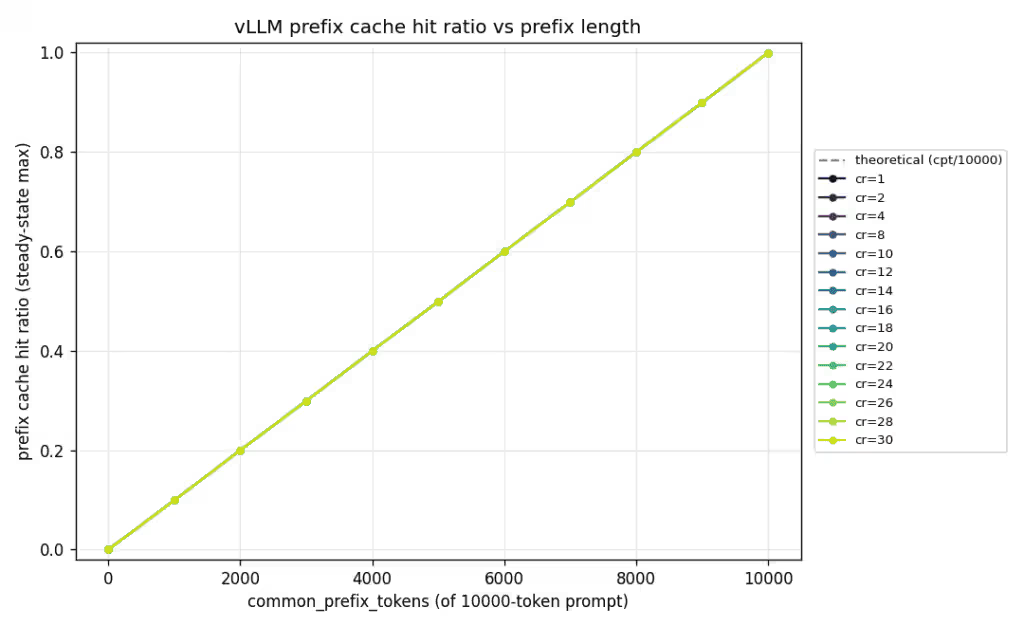
固定の10Kトークンのプロンプトに対し、共通プレフィックスを0〜10Kトークンへ伸ばすと、キャッシュヒット率は線形に上がります。
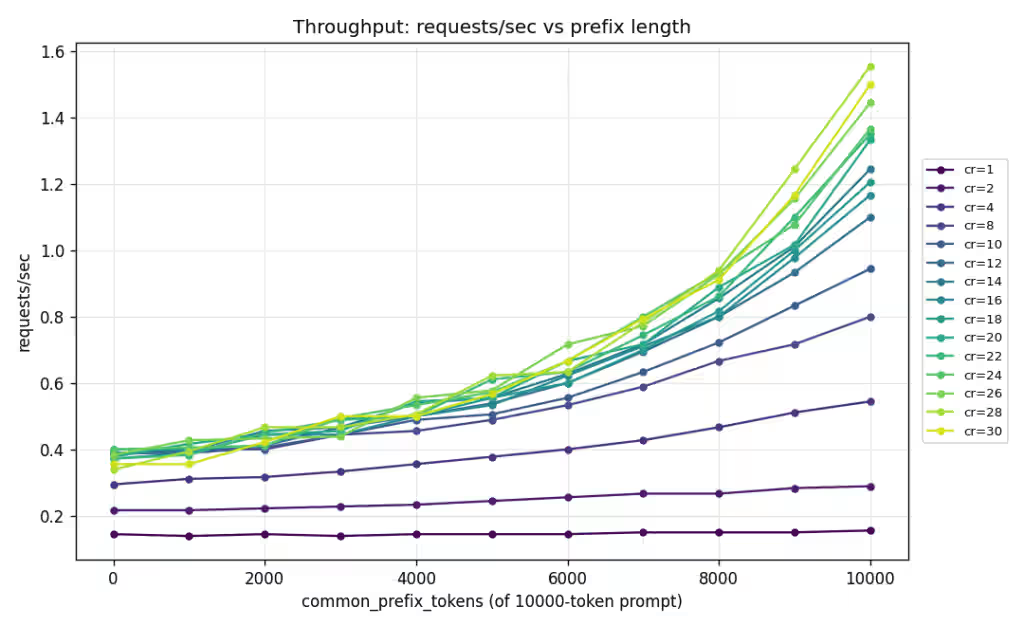
共通プレフィックスが伸びるとスループットが増えます。特に同時実行数が多い場合、プリフィルの繰り返しを省くことで毎秒より多くのリクエストを維持できます。
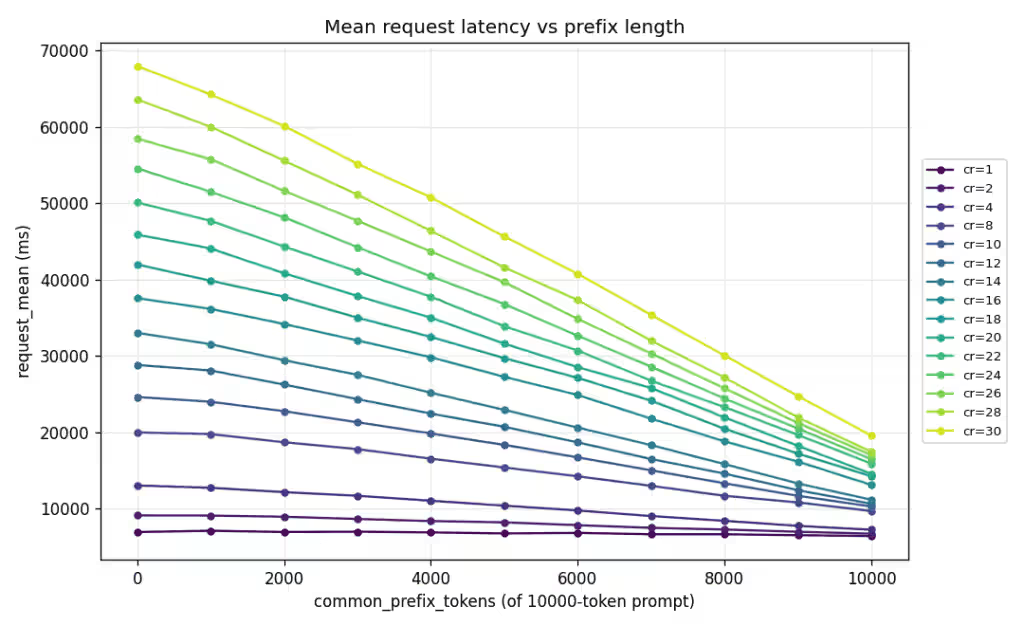
再利用が増えるほど平均レイテンシは下がり、同時実行数が多い設定ほど改善が大きくなります。
同時実行数が少ない場合、ヒット率の改善は多少役立つ程度です。同時実行数が多いと、同じ改善がはるかに大きなシステム効果を生みます。プロンプトのうちキャッシュから得る部分が増えるほど毎秒リクエスト数が大きく上がり、平均レイテンシも下がります。低下が最も急なのは同時実行数が多い設定です。KV キャッシュが単一リクエストのレイテンシ対策ではなく、システムの最適化であるなら、予想される動作です。
この実験は単一ノード上の小さなモデルなので、それだけで分離型アーキテクチャの議論を証明するわけではありません。しかし、プレフィックスヒットがサービング経路からプリフィル処理を取り除き、同時実行数とともにシステム全体の利点が増えることは確認できます。分離構成の仮説は、プリフィルとデコードを別のハードウェアで実行し、KV キャッシュを第一級のオブジェクトとして受け渡すと、この効果がさらに強まるというものです。
適切なワークロードでは、すでに効果がある
プレフィックスキャッシュで共有できる形は一般に限られています。それでもエージェントのワークフローには、想像以上に自然に適合します。ただし、その理由はコンテキストの種類で異なります。
システムプロンプトは簡単な例です。リクエスト間で安定し、プロンプトの先頭にあるため、典型的なプレフィックスヒットになります。同じバックエンドへ一連のツール呼び出しを行うエージェントは、毎回同じ2K〜8Kトークンのシステムプロンプトを再利用します。固定システムプロンプトの複数ターン会話では、指示ブロック全体を再利用します。リポジトリのコンテキストが安定したコード生成エージェントは、プロジェクトの説明とファイル概要を再利用します。この種類では、リクエスト間のキャッシュは単純です。
他のコンテキストには注意が必要です。会話履歴はターンごとに増え、変化します。ツール呼び出しの例は並べ替えられたり交換されたりし、検索チャンクは RAG のクエリごとに変わります。これらは、完全に同じプレフィックスを持たなくてもリクエスト間で材料を共有します。そのため効果は、位置が安定した部分(プレフィックスキャッシュが扱える部分)と、可変の部分(CacheBlend のような仕組みが必要な部分)の割合に左右されます。
よりよい解決策を目指す研究
クエリごとに検索チャンクが変わる RAG や、呼び出しごとに異なるツール結果など、複雑なパターンでは、完全なプレフィックス一致がなくても多くの材料を共有できます。計算の大半を再利用できるはずでも、従来のプレフィックスキャッシュではミスになります。
CacheBlend は、この領域の研究の1つです。現在のリクエストに必要なものと意味的に近いキャッシュエントリを使い、異なる部分だけ選択的に再計算するキャッシュ修復を探っています。修復が十分安ければ、個々のキャッシュをより多くのリクエストで再利用でき、メモリを増やさずにヒット率が上がります。
これはまだ研究段階で、解決済みではありません。現在、主要な推論フレームワークにチャンク単位の KV 再利用は搭載されていません。選択的な再計算には独自のレイテンシがあり、品質維持はワークロードに依存し、トレードオフの測定方法も発展途上です。それでも有望な方向です。キャッシュエントリを柔軟に使えるほど、同じメモリ予算で実効ヒット率が高まります。
プレフィックスキャッシュは、増え続けるワークロードで「キャッシュは有効か」に答えています。残る問いは、それ以外のどれほどをキャッシュ可能にできるかであり、その答えを探るのがキャッシュ修復です。
リクエストの状態からシステムの基本要素へ
単一ノードの独立した最適化として KV キャッシュを評価すると、あまり合理的には見えません。メモリは高価で、プレフィックスによる再利用には制限があります。
しかし、その下のアーキテクチャは変わっています。プリフィルとデコードの分離が適切なインターフェースを生みます。より優れたアテンション機構が、保存・移動する対象を小さくします。高速なネットワークと SSD が転送コストを下げます。キャッシュ修復は、厳密なプレフィックスを超えた再利用を可能にするかもしれません。GPU 容量の希少さは、プリフィルを繰り返す理由を弱めます。
これらが合わさり、KV キャッシュは一時的な中間状態から、推論システムの基本要素へ変わりつつあります。