推論で最も高くつく言葉は「今すぐ」
誰も待っていない非同期エージェントは、推論の経済性を変えます。最大のコスト削減策は、今すぐ実行する必要のない仕事を見極めることかもしれません。
 Allen Helton
数週間前、かなり大きなリファクタリングを Claude に任せ、ノート PC を閉じて農作業に出かけました。どれほど時間がかかるかはわかりませんでしたし、気にもしていませんでした。数時間後に戻ると、作業は終わっていました。
これは、もっと不思議に感じてもよいことです。推論といえば、通常は速度が大きなテーマです。最近の記事で目にするのは、最初のトークンまでの時間(TTFT)、テールレイテンシ、人が集中を保てるよう往復時間をミリ秒単位で削る話ばかりです。それなのに私は、特にトークンを多く消費する作業をノート PC から実行し、所要時間をほとんど気にしていませんでした。
Doubleword CEO の Meryem Arik は、最近の講演 Inference for Async Agents in Production で、この感覚を的確に言葉にしていました。「誰が待っているのか」という単純な問いに、私は納得しました。
誰も待っていなければ、推論のコストはまったく違って見えます。
誰も見ていない前提で推論をスケジュールする
チャットのような同期システムでは、人が処理の流れに直接入っています。何の反応もなく待たされると、本当に動いているのかとあちこちクリックし始めます。非同期システムでは、エージェントが作業を分岐させ、30分ほど動き、終わったら通知するかもしれません。画面を見ている人はいません。利用者は別のことをしているので、35分で終わるか45分で終わるかは、あまり問題にならないことも多いのです。
UX の細かな違いのように見えますが、基盤のほぼすべての判断に影響します。
「誰が待っているのか」は、出発点として正しい問いです。より具体的には、どれだけ待たせてよく、その後ろで何が止まっているのか。人が画面を見ていなくても、エージェントのクリティカルパス上の呼び出しには期限があります。非同期ワークフローは、その期限を決める余地を広げてくれるのです。
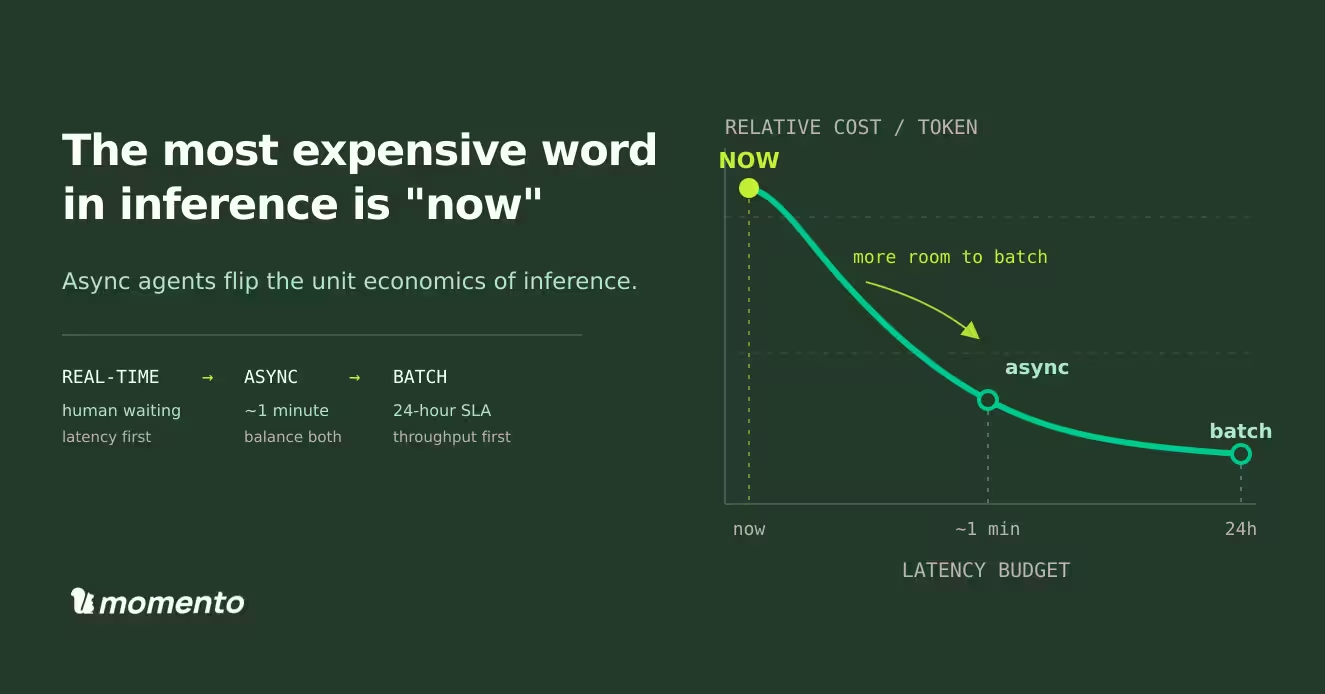
人を待たせる時間は、システム内で最も高くつく時計です。「人にとって十分速い」という要件が、プロビジョニング、バッチ量、購入するチップ、待機させる余剰容量を決めます。「今すぐ答えがほしい」と言えば、すべてが高価になります。人をループから外すと、その時間制約は緩み、他のすべてに課していた値札も変わります。
バッチ処理を再発明した
対話型のデータベースクエリと夜間の分析ジョブなど、私たちは過去にも同じことをしてきました。午前2時に動くバッチより、利用者が見つめる Web リクエストを優先します。テクノロジー業界は、私が生まれる前から「誰かが待っている」と「誰も待っていない」を分けてきました。
推論は、データベースやジョブキューが何十年も前に学んだことを、よい意味で急速に追体験しています。若い分野の難題がインフラの世界では既知なら、実績のあるパターンをすぐ借りられます。
Meryem は中心的な緊張関係を、レイテンシ、品質、スループットという従来の三角形で説明します。選べるのは2つです。
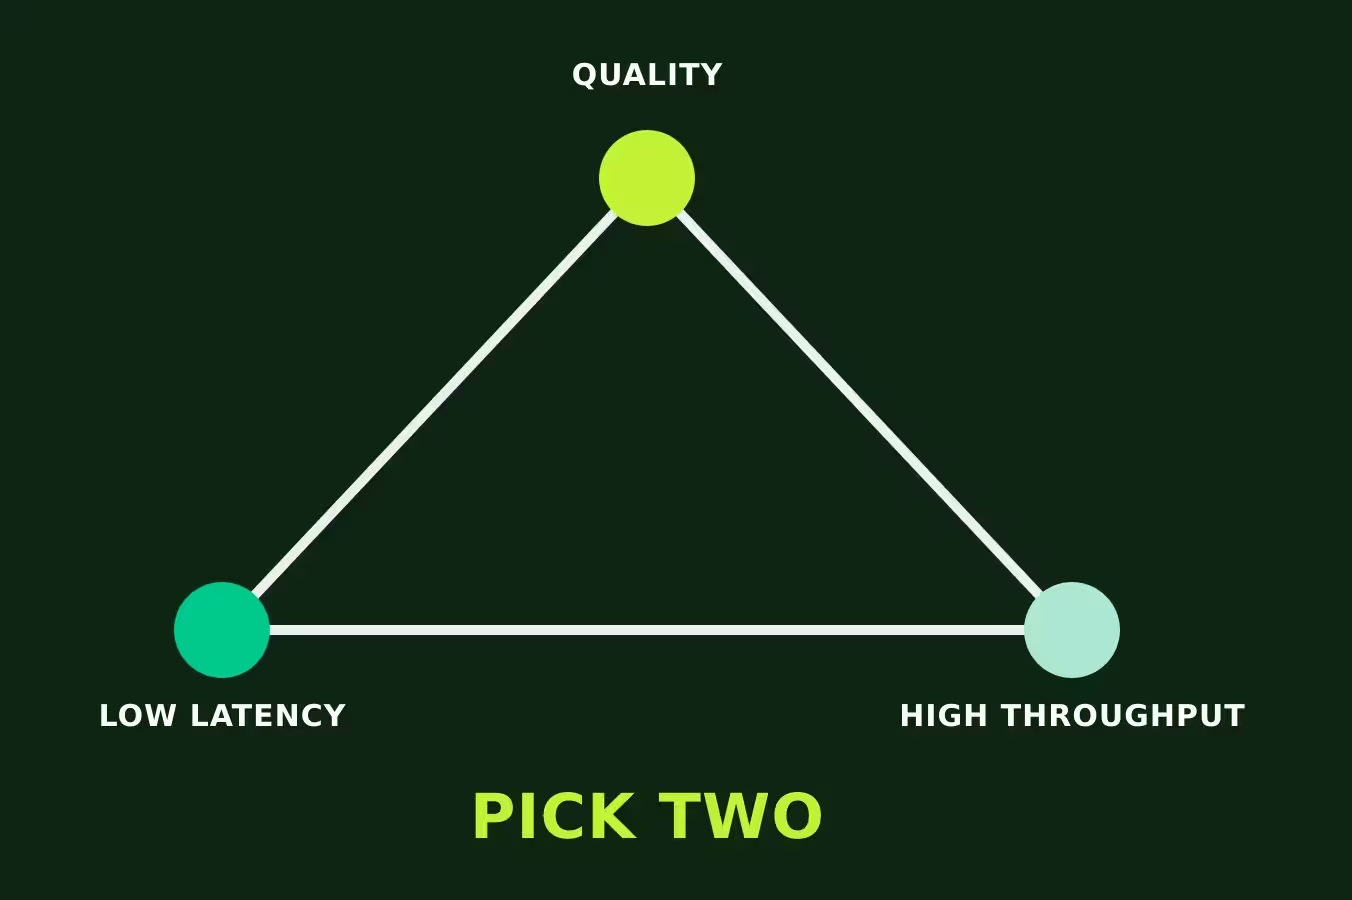
チャットアプリはレイテンシと品質を選びます。非同期エージェントは品質とスループットを選び、レイテンシを許容します。長時間動くエージェントに主に必要なのは、できるだけ賢いモデルです。サブエージェントを管理し、複数タスクを扱いながら、2時間の作業で一貫性を保つためです。会話の速度でトークンを返しても、利点にはなりません。
バッチ処理の本質はスケジューリング
バッチサイズの計算は複雑です。Meryem の講演の例では、バッチサイズ1で対話性を最大化したモデルは、100万トークンあたり約$4.65でした。同じモデルに十分な同時処理を与え、スループット重視に調整すると、100万トークンあたり約9セントになります。
この例では、重みも品質も同じなのに、コストに50倍の差があります。採算に大きく影響します。
ただし条件があります。大きなバッチが最良の経済性を生むのは、互換性のある待機中の仕事が十分にあり、バッチを埋め続けられる場合だけです。空き枠は、お金を払っているのにトークンを生まない半導体です。需要が突発的で予測困難なまま、バッチを埋め続けることが難題です。
以前、私は別の角度から、GPU はテクノロジー分野で最も高価な資源なのに、うまく使えていないと論じました。バッチサイズも同じ話です。高い使用率が最重要で、その成否はスケジューラーで決まります。
キューこそが製品になる
Meryem の説明で印象的だったのは、ほとんどのプロバイダーがリアルタイムのサーバーレスエンドポイントで赤字になっているという点です。「今すぐ」の追加コストに行き着きます。ばらつくトラフィックに対して人へ高速な応答を約束するには、ピークに合わせて用意し、間の低負荷時の遊休コストを負担しなければなりません。遊休計算資源は、資金を燃やしているのと同じです。
待てる仕事なら、バッチキューは強力な道具になります。負荷の低い時間へ仕事を回し、すでに費用を払っている空き時間を埋められます。中断を許容できる、またはチェックポイントを取れる作業なら、スポットインスタンスで余剰計算資源を使えます。SLA を考慮したルーティングで、緊急リクエストを先に回せます。同じ mixture-of-experts の重みを使うリクエストを連続させ、毎回エキスパートを再読み込みしないよう、キューを並べ替えることもできます。
「今すぐ」を約束しなくなれば、スケジューラー、ルーター、あるいはキューを管理するものがシステムの中心になります。価値はそこへ集まり、全体もその方向へ進んでいます。ハードウェアとモデルがコモディティ化すると、優位性はルーティング、配置、オーケストレーションへ移ります。「次に何を動かすか」を決める者が、経済性を握ります。
待てる時間を分類する
私は習慣で、すべてをリアルタイム扱いしてしまいます。相手の「人間」が、別の6つのことをしているエージェントであっても、息を詰めて待つ人がいるかのように扱います。その結果、不要な仕事にも「今すぐ」の追加コストがかかります。
Doubleword はレイテンシを、リアルタイム、非同期(約1分)、バッチ(24時間)に分類しています。先ほどの50倍のコスト差は、どの区分を選ぶかに帰着します。私を含め、多くの人が反射的に高価な方を選んでいます。
この記事を読んだ直後にできる、地味ですが有用な作業があります。エージェントの呼び出しを1つずつ見て、人が待っているかを確認することです。該当するものの少なさに驚くかもしれません。バックグラウンドでコンテキストを取る呼び出しでは、人は待っていません。11段階中の4段階目を処理するサブエージェントも同じです。夜間の要約ジョブなら、なおさらです。
近い将来、コンテキスト、依存関係、期限からレイテンシ区分を推定する賢いルーターが登場し、手作業で分類しなくて済むようになるでしょう。それを効率よく実現できれば、スケジューラーが各仕事の許容待ち時間に合わせて最適化でき、システムコストは大きく下がります。それまでは、全体を初期設定で「今すぐ」にするのではなく、モデル呼び出しごとに現実的なレイテンシ予算を与えることから始めましょう。
ここで話したことは、インフラの世界では長年使われています。Momento の共有キャッシュも同じ発想です。高価な状態を保存し、すでに費用を払った処理を再利用し、希少な資源を遊ばせず働かせます。推論は、こうした古くからの発想に、非常に大きな新しい金額を付けています。
同じ課題に取り組んでいる方は、ぜひ情報交換しましょう。
開発を楽しんでください。