インデックスの数を数えるのはやめよう
50個の追加インデックスでは書き込みは遅くならないのに、ベクトルフィールド1つで11倍遅くなります。valkey-search がそう動く理由は、予想とは違いました。
 Allen Helton
自由文検索は手ごわいものです。ユーザーが「100ドル以下のワイヤレスイヤホン」と説明することもあれば、買い替えたい商品の SKU を貼り付けることもあります。どちらも正当な使い方ですが、前者にはベクトル検索、後者には語句の照合が必要です。私は両方を扱うため、valkey-search に多くの時間を費やしてきました。想像できるように、1つのインデックスでは足りませんが、同じキーに2つのインデックスを設ければ対応できます。
ただ、インデックスを倍にするのは不安でした。性能への影響がわからなかったからです。超低レイテンシが必要で Valkey を使っているのに、工夫が裏目に出ては困ります。
もちろん、1つから2つなら大問題ではないでしょう。しかしインデックスは増えていくものです。カテゴリで商品を絞るために1つ作り、1か月後に価格を足し、検索チームがベクトルフィールドを欲しがり、決済チーム、配送チームも自分たちのキーに索引を付ける。気づけばリポジトリに12個の FT.CREATE があり、全体の責任者はいません。
直感では、性能は数に反比例しそうです。valkey-search の各インデックスはキープレフィックスを購読します。一致するキーを書くと、そのインデックスの変更キューにエントリが入り、すべて処理されるまでクライアントがブロックされます。これが書き込み後の読み取り整合性を保証します。インデックスが12個なら、エントリも12個で、待ち時間も12倍になるのでしょうか。
そこで、追加インデックスのコストを調べるベンチマークを作りました。すると、私は大きく間違っていたとわかりました。
構成
サーバーは物理8コアの r7i.4xlarge で、Valkey 9.1.1 と valkey-search 1.2.1 を実行しました。valkey-search は書き込みワーカープールを8スレッドに設定します。測定中のバックグラウンド保存の fork がレイテンシを乱さないよう、永続化は無効にしました。負荷は同じプレイスメントグループの別の c7i.8xlarge から、384接続で生成しました。
各書き込みは同じ4.6KBの商品ハッシュで、カテゴリ、価格、SKU、タイトル、説明、1024次元の埋め込みを含みます。負荷生成器は予定に従って送信し、実際に送信できた時刻ではなく、送るはずだった時刻から各リクエストを計測します。これについては後述します。各測定点を25秒ずつ3回実行し、中央値を取ります。
使われていないインデックスにもコストはあるか
先ほどのとおり、インデックスはキープレフィックスを購読します。一致しないキーを追加・更新しても遅くなるのでしょうか。このテストでは、インデックスの存在自体が他の処理を遅くするかを調べます。
product: キーへの同じ書き込みを、2つの構成で実行しました。product: 上のインデックス1つと、それに無関係なプレフィックスのインデックス50個を加えた構成です。
| 構成 | 維持できる書き込み数/秒 | 2,000/s時の p99 |
|---|---|---|
product: 上に1インデックス | 32,000 | 2.18ms |
| 同じインデックス + 他のプレフィックスに50個 | 32,000 | 2.17ms |
どのレートでも、測定できる差はありませんでした。
プレフィックスの購読がトライ木に格納されているためです。product:88213 を書くと、valkey-search はトライ木をたどり、一致するインデックスだけに通知します。orders: のインデックスには届きません。FT.INFO idx:other0 の mutation_queue_size は実行中ずっと0のままで、この設計どおりの動作を確認できました。
リポジトリ内で増えた雑多なインデックス自体が、書き込みを遅くしているわけではありません。処理経路に入るのは、書くキーとプレフィックスが一致するものだけです。
一致するインデックスの影響
では、一致するインデックスが複数あるとどうなるのでしょうか。同じワークロードで、今度は product: に同一のインデックスを複数追加しました。
product: 上のインデックス数 | 書き込み数/秒 | 索引付けジョブ数/秒 |
|---|---|---|
| 0 | 80,000 | 0 |
| 1 | 33,636 | 33,636 |
| 2 | 20,000 | 40,000 |
| 4 | 16,818 | 67,272 |
一致するインデックスごとに索引付けジョブが作られ、すべて終わるまで書き込みは完了しません。確認するため、Valkey の search_ingest_hash_keys を、同じ時間内に完了した書き込み数で割りました。その値に書き込みレートを掛けて、ジョブ数/秒の列を計算しました。
当然ながら、最も高くつくのは最初に索引付けを有効にする段階です。0から1にすると書き込みレートが58%下がり、2つ目でさらに41%下がりました。2から4へ倍にしても低下は16%だけです。追加するたびに、増分のコストは小さくなりました。
インデックスを増やすと、同じサーバーが処理する索引付けの総量は増えます。1つでは毎秒33,636ジョブ、4つでは67,272です。後から2倍の仕事をこなせたのですから、1〜2個の時点では書き込みプールを飽和させていなかったことが明らかです。
索引付けジョブは物理コア数に合わせたプールへ分散され、クライアントのブロック用ハンドルは、その接続上の1つのブロックに集約されます。書き込みは最も遅い単一ジョブを待つため、4つのインデックスが1つの4倍のコストにはなりません。
ただし、何が制約なのかはわかっていません。ジョブがプールへ届く前にメインスレッドで行う、インデックスごとの管理処理ではないかと推測していますが、測定はしていません。
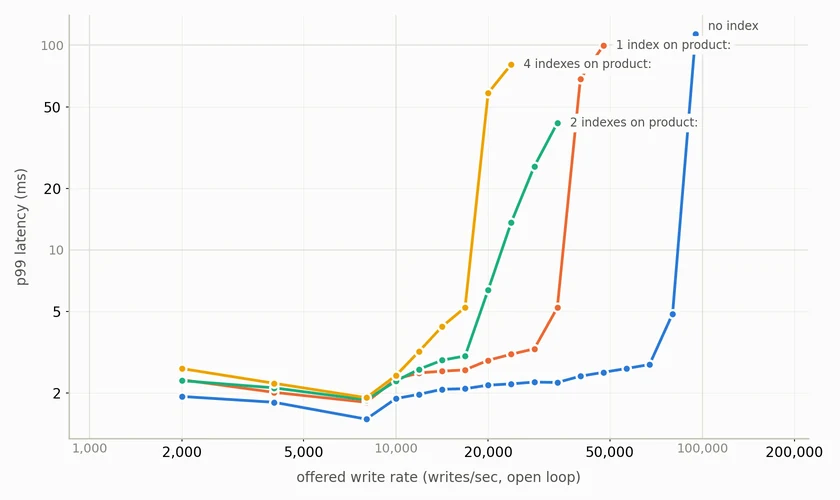
注:一致するインデックスを増やしても、手遅れになるまでレイテンシの増加に見えない場合があります。毎秒2,000件では、1つと4つの差は1ミリ秒以内でした。消費しているのは容量の余裕なので、正常なシステムの p99 を見ても気づきません。必要になって初めて、余裕がないとわかります。
ベクトルフィールドは影響が違う
ここまでのベンチマークは、通常のフィルター用 TAG と NUMERIC フィールドを使っています。そこで最初のテストに戻り、1インデックスの構成へ1024次元の HNSW ベクトルフィールドを1つ追加しました。再実行すると驚く結果でした。
毎秒32,000件の書き込みが、2,828件になりました。
フィールド1つで、スループットに11倍の差です。概算では、8本の書き込みスレッドに分散したベクトル挿入1回あたりの CPU 時間は2〜3ミリ秒です。さらに性能は急激に崩れます。投入レートを約40%増やすと、破綻しました。
| 投入書き込み数/秒 | p99 | 書き込みキュー深度 |
|---|---|---|
| 2,828 | 5.65ms | 4 |
| 4,000 | 2,046ms | 376 |
レイテンシは約5ミリ秒から2秒へ悪化します。ほぼ空だったキューは376件になり、それ以上のどのレートでも、その深さにとどまりました。境界より下なら正常、超えればすべてが遅れます。容量計画では、高頻度のプレフィックス上のインデックスにベクトルフィールドがあるかを必ず確認してください。
ベクトルフィールドは他の一致するインデックスにも影響するか
2つのインデックスが必要だった検索機能の話に戻ります。1つで両方をできない理由は、ストップワードです。テキスト処理の設定はインデックス全体に適用され、句読記号で単語を分けてから、ストップワードを削除します。IT-500 は it と 500 に分かれ、it はストップワードなので、500 だけが索引に入ります。NOSTOPWORDS を有効にすると、説明フィールドの the、is、and、it などもすべて索引付けされます。そこで片方だけ有効にするため、2つのインデックスが必要です。
では、最初のインデックスにベクトルがある場合、2つ目にはどれほどコストがかかるのでしょうか。先ほどのテストで、ベクトルがスループットを大きく下げることはわかっています。
| 構成 | 維持できる書き込み数/秒 | p99 |
|---|---|---|
| 意味検索(TAG + NUMERIC + HNSW) | 2,828 | 5.29ms |
| 意味検索 + 完全一致(TEXT、NOSTOPWORDS) | 2,828 | 5.44ms |
差は約3%でした。完全一致用インデックスは、この実行中に141,408個のテキストフィールドを処理しました。両方の変更が同時にプールへ入り、書き込みは遅い方、つまりベクトルを待ちます。すでに HNSW のコストを払っているなら、語句検索用インデックスの追加レイテンシは実質ほぼありません。
得られた教訓
実験開始時の問いが間違っていたとわかりました。インデックス数が多いと性能が極端に落ちると思っていましたが、そうではありません。本当の問いは、書くキーに一致するインデックスの中に、どんなフィールドがあるかです。そう考えると安心できます。
間違った問いに答えようとする間に、ベンチマークについても学びました。
本記事の維持可能な書き込み数は、どれももっと大きく見せることができました。最大レートでは、インデックスなしの構成は毎秒128,000件を完了しましたが、表には80,000件と書いています。そのレートでは、各リクエストがまずキューで1.9秒待っていたからです。使用率100%のサーバーは流入と同じ速度で処理するので、スループットは完璧に見えてもレイテンシを犠牲にします。表には、p99 が妥当な範囲にとどまる最高レートを使いました。
冒頭の4行の表を信じられるまで、3回測定しました。初回は段階ごとに1.4倍ずつ上げたため、2インデックスと4インデックスが同じ16,000の段階に入り、最初は3つ目と4つ目に影響がないと思いました。実際には両方とも段階の間で破綻しており、測定の刻みでは場所を区別できませんでした。そこで1.19倍刻みにすると、明確に分かれました。しかし、その測定は14,000から始まっており、すでに曲線の上方だったため、低負荷時のレイテンシを測れていませんでした。維持可能なレートの基準は低負荷時に対する相対値なので、2回目は甘い基準で評価していたことになります。3回目は2,000から始め、表にはその結果を使いました。レートの段階幅より小さな差は区別できず、急変前の平坦部分を見ていなければ急変点もわかりません。
自分で試す
ベンチマーク、スクリプト、結果は GitHub で公開しています。数値を確認したい方、異論がある方も、ぜひ試して結果を教えてください。
自分の Valkey クラスターで同じテストをするなら、次の3コマンドを実行できます。
FT.INFO <index> # shows mutation_queue_size (write backlog) for the specified index
INFO search # shows search_writer_queue_size for the whole pool
CONFIG SET search.info-developer-visible yes # unlocks per-field-type counters like search_ingest_field_vectorこれらの変更は元に戻せるので、既存クラスターでも低コストで実験できます。FT.DROPINDEX は即座に完了し、データ自体はもともとインデックス内にありません。構成を追加し、測定し、不要になったら削除してください。
開発を楽しんでください。