LMCache + Momento で TTFT を 50% 超削減
LMCache と Momento Accelerator を使って KV キャッシュをリモートストレージ(Valkey + S3)へオフロードすることで得られる性能向上を検証します。
 Khawaja Shams
 Daniela Miao
 Tony Valderrama
本記事では、LMCache と Momento Accelerator を使って KV キャッシュをリモートストレージ(Valkey + S3)へオフロードすることで得られる性能向上を検証します。
本シリーズでは、分散 KV キャッシュ、ルーティングの最適化、クラスターのオーケストレーションなどの手法が、大規模な推論クラスターにもたらす性能向上を検証します。本記事では、LMCache と Momento Accelerator を使い、KV キャッシュをリモートストレージ(Valkey + S3)へオフロードする方法に注目します。
Momento はハイパースケールのキャッシュとルーティングを専門とし、Snap、Coinbase、Paramount、Capcom などの企業向けに、世界最大級の Valkey / Redis クラスターを運用しています。Momento Accelerator for AI(MAX AI)は、vllm や sglang などの一般的なフレームワークと連携する高性能コンポーネント群です。
KV キャッシュの追い出しが GPU の性能を損なう
一般的な推論では、システムプロンプト、データの断片、直近の履歴など、同一の内容が各リクエストのコンテキストウィンドウの大きな部分を占めます。そのデータを繰り返し処理すると、推論クラスターに継続的な負担がかかり、貴重な GPU サイクルを不要な重複作業に費やすことになります。
もちろん、後続のリクエストが同じ GPU に届けば、高帯域幅メモリ(HBM)内の既存のキャッシュを利用して、プリフィル処理の大部分を省略できます。最先端の KV キャッシュオフロードの仕組みは、推論ワーカー上のローカルストレージ(DRAM / NVMe)によって HBM を拡張することに重点を置いています。
しかし、特に大規模な環境では、ローカルキャッシュだけでは柔軟性が足りず、追い出しや無駄な再計算を避けられません。
分散 KV キャッシュオフロードの仕組み
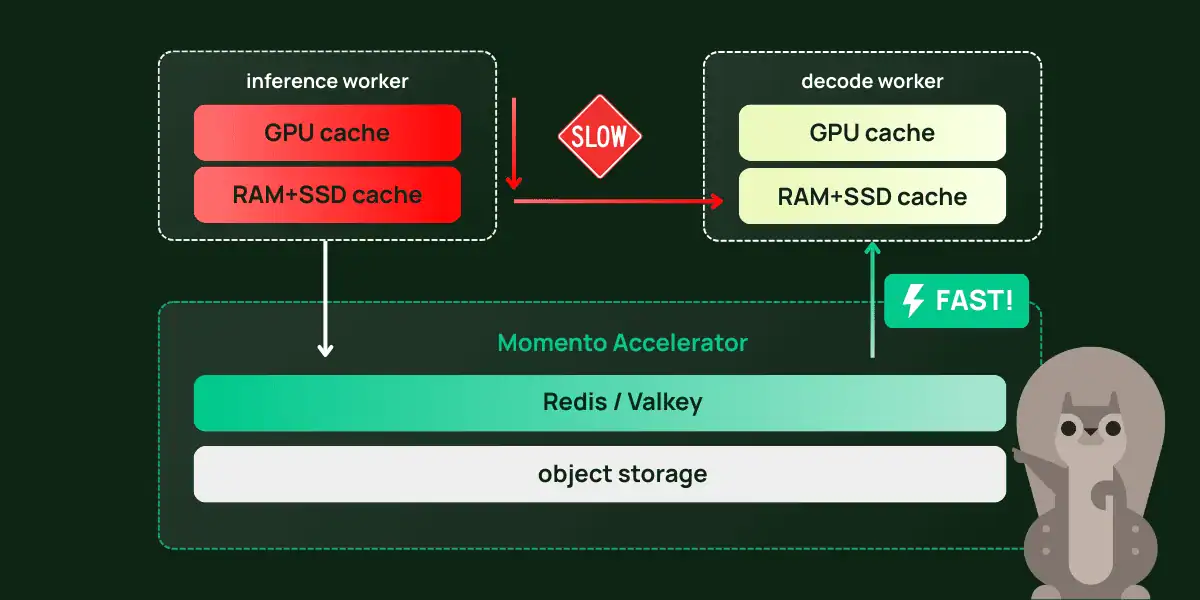
分散キャッシュオフロードでは、大量のデータに高速でアクセスできるよう設計された専用のトークンストアを活用し、過去の計算結果を捨てずに済むようにします。
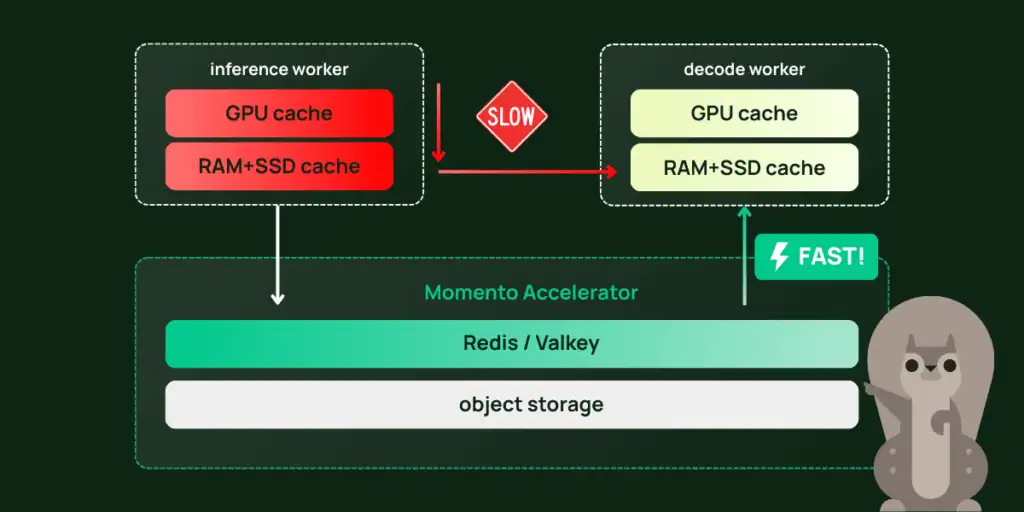
分散 KV キャッシュオフロードは、ローカルとリモートの複数のストレージ階層への統一されたアクセスを提供し、限られた GPU メモリを拡張します。高帯域幅の転送エンジンで、他の推論ワーカーや専用のストレージノードを接続します。これにより、安価で永続性のある PB 規模のストレージを利用でき、同じデータを再計算するより短い時間で推論ワーカーの KV キャッシュを復元できます。
Momento Accelerator for S3(MAX S3)は、S3 の手前に Valkey を配置する低レイテンシのオブジェクトストアであり、高性能なトークンストアに適しています。MAX S3 は、ライブ動画配信、マルチプレイヤーゲーム、IoT 分析、Web スケールの消費者向けアプリなど、さまざまなユースケースの本番ワークロードで、ペタバイト規模のデータを Tbps のスループットとサブミリ秒のレイテンシで処理しています。
LMCache + Momento Accelerator でコールドスタートのレイテンシを削減
このベンチマークでは、標準的なオープンソースコンポーネントである vLLM と LMCache に Momento Accelerator を組み合わせ、キャッシュの性能を評価します。
ベンチマークでは、それぞれ異なる長いコンテキストを順に処理します。これは、複数ターンの会話やエンタープライズ RAG など、一般的なマルチテナントのワークロードに似ています。ウォームアップ段階で各コンテキストを一度ずつ送信し、分散キャッシュにデータを保存します。その後、ローカルキャッシュを消去して各コンテキストを再送信し、コールドスタート時の TTFT を測定します。
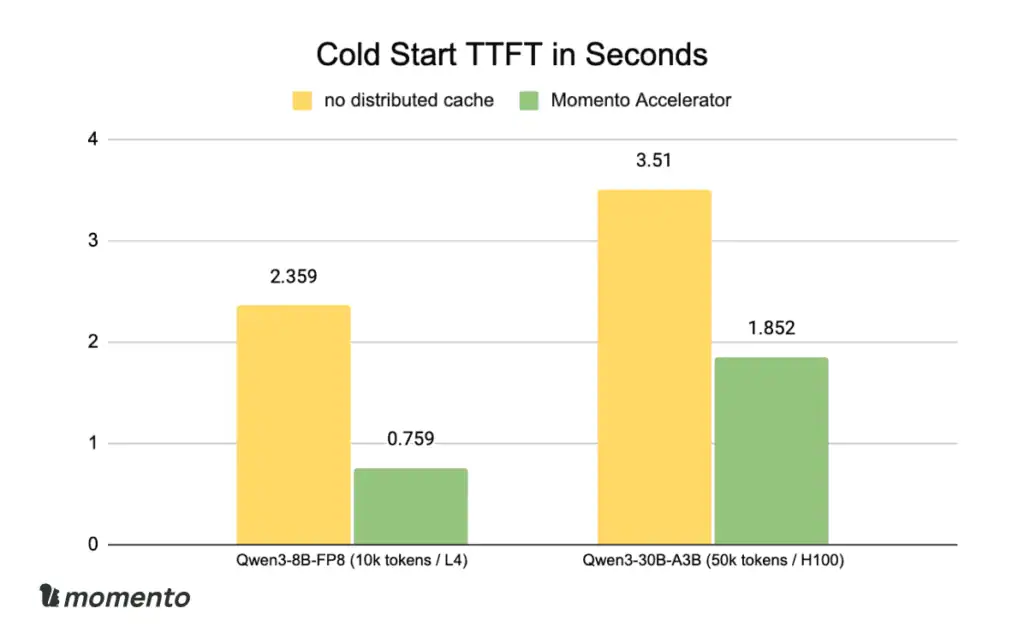
永続的な分散キャッシュにより、コールドスタート時の TTFT を 50% 超削減できました。これは大きな成果です。安価で永続性のあるストレージから新しいノードをすばやくウォームアップできることは、効率的で先回りしたクラスター管理の基盤になります。
今後の取り組み
Momento Accelerator と LMCache、vLLM の統合は、わずか 1 週間の調査から生まれました。今後さらに改善を検証していきますので、ご注目ください。
超低レイテンシの分散システムに関する知見を生かし、LMCache と vLLM の上位コンポーネントを Rust で最適化できる機会を数多く見いだしています。特に、ルーターとコントロールプレーンの統合によって、キャッシュのプリフェッチや負荷を考慮したスケジューリングを用いた、先回りしたクラスター管理が可能になると期待しています。
Momento Accelerator で Valkey + S3 をトークンストアとして導入
Momento Accelerator for S3 は、低レイテンシで永続性のあるストレージを簡単に導入できる階層型オブジェクトストアです。ハイパースケールのキャッシュ運用経験を生かし、vLLM + LMCache 向けに独自の高帯域幅コネクターを開発しました。このコネクターは現在も急速に開発と改良を進めています。本番ユースケースのベンチマークについて支援が必要な場合は、お問い合わせください。