KV キャッシュは、キャッシュの問題ではない
KV キャッシュをどこに保存するかより、いつ GPU に届けるかが重要です。TTLB とプリフェッチから、GPU の利用効率を考えます。
 Allen Helton
業界は KV キャッシュをどこに保存するかを議論しています。しかし、問うべきことはそこではありません。
AI アシスタントとの会話を中断してコーヒーを取りに行きます。10 分後に戻って追加の質問をすると、少し遅く感じます。待機中の表示が、いつもより長く続きます。簡単だと思った質問なのに、モデルは必要以上に考え込んでいるようです。
実際に、余分な計算をしています。離れている間にすべてを忘れ、一から再計算しているのです。この無駄な作業には実際の費用がかかります。そして、有力な解決策として提案される階層型 KV キャッシュストレージは、別の問題を解こうとしています。
LLM の KV キャッシュが従来のキャッシュと異なる理由
キャッシュのインフラは通常、小さなオブジェクトを中心に作られています。1 キロバイト、4 キロバイトのデータを、毎秒数百万のトランザクションで扱います。DynamoDB や Valkey を開発したエンジニアは、オブジェクトごとのレイテンシを最小化し、IOPS を最大化し、小さなものを極めて高速に動かすため、何年も最適化してきました。
その経験は、KV キャッシュを考えるうえで有用な背景です。利用効率、追い出しポリシー、ヒット率の基本原則は今も当てはまります。しかしワークロードの特性は大きく異なり、解決策をそのまま持ち込めません。持ち込めると考えてしまうところに、現在の議論の誤りがあります。
一人のユーザーの会話コンテキストだけで、数ギガバイトになることがあります。大きなモデルではさらに増えます。多くのユーザーが同じ文書やナレッジベースに質問すると、同じ巨大なオブジェクトを、しばしば同じ宛先へ繰り返し動かします。オブジェクトが膨らむため、トランザクションレートは大きく下がります。
この規模では、IOPS はもはや主なボトルネックではありません。重要なのは、ネットワークのスループットを使い切り、大きなオブジェクトをできるだけ効率的に動かすことです。ネットワークカードが制約となり、RAM、SSD、リモートストレージのどれを選ぶかの重要性は、多くの人が当初考えるよりはるかに低くなります。従来のキャッシュ調整で身に付いた習慣は、誤った最適化へ導きます。
最適化する指標が違う
GPU は、数 GB の KV キャッシュオブジェクトがすべて届くまで、それを使えません。
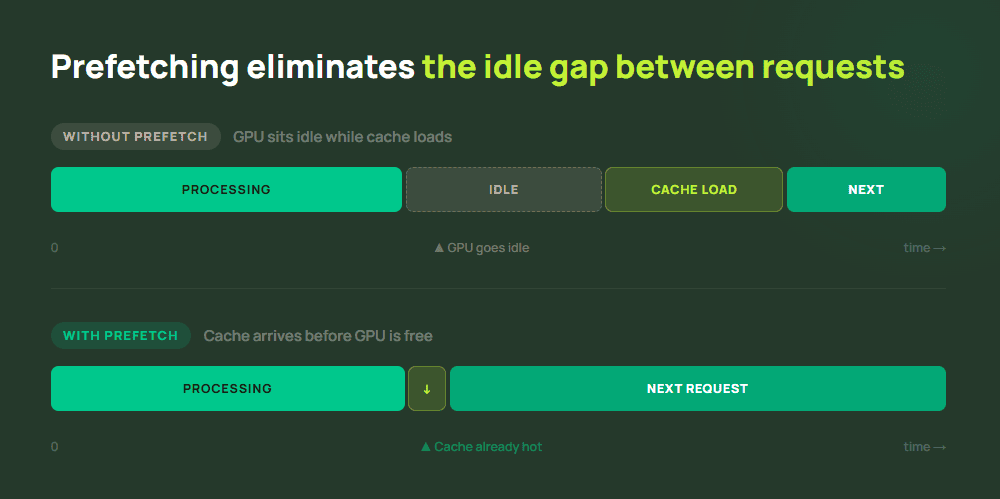
つまり、最後のバイトまで届く時間、TTLB(Time To Last Byte)こそ最適化する価値のある指標ですが、多くのチームは追跡していません。
代わりに、なじみのある調整手段として、ストレージ階層の選択に注目しがちです。RAM は速く、SSD は遅く、リモートはさらに遅い。買える範囲で最速の階層を選べば解決、という考え方です。しかし、ギガバイト単位のオブジェクトをネットワーク越しに動かすと、ストレージ媒体の読み取りレイテンシは転送時間に埋もれます。速い階層で削れるのはマイクロ秒ですが、ネットワーク転送にはいずれにせよミリ秒かかります。
だからこそ、従来の低レイテンシキャッシュでは候補にならないオブジェクトストアなどのリモートストレージも、KV キャッシュでは有力な選択肢になります。スループットが制約なら、制約はスループットです。それを受け入れると、ストレージの議論の大半は決着します。
自動的には解決しないのが、プリフェッチのタイミングです。GPU が次に必要とする KV キャッシュを予測し、その GPU が空く前に読み込み始められれば、転送時間を事実上クリティカルパスから外せます。現在のリクエストが終わったときには、コンテキストが既に用意されています。100 ミリ秒の読み込み時間は人間には気づかれなくても、時間単位で課金される GPU には非常に高価です。適切なプリフェッチでその待ち時間を縮めれば、どのストレージ階層を選んでも取り戻せなかった利用効率を回復できます。
GPU の利用効率はプリフェッチの問題
100 マイクロ秒未満のレイテンシで動くインフラを構築するには、アプリケーション層より下に入り、OS の調整、ネットワークスタックの設定、ハードウェアの選択に取り組みます。そこで早く学ぶのは、ボトルネックはほとんどの場合、予想した場所にはないということです。明らかな箇所を最適化して測定すると、見ていなかった場所へ制約が移ったと分かります。
KV キャッシュも同じ性質を持ちます。業界がストレージ階層化を主要な手段としたのは、目に見えて扱いやすいからです。よいハードウェアを選び、費用を増やし、速くする。その論理はあるところまで機能しても、やがて通用しなくなります。実際の制約は、そもそもストレージ媒体ではなかったためです。
GPU の利用効率を高める要点は、どのコンテキストを読み込むべきかを知り、GPU が遊休状態になる前に用意しておくことです。ストレージ階層は、その問題の入力条件であり、答えではありません。
Momento は、長年にわたりアプリケーション層の下にあるレイテンシの問題を解いてきました。LLM の KV キャッシュは、次に取り組む課題です。GPU インフラに取り組み、知見を交換したい方は、ぜひご連絡ください。